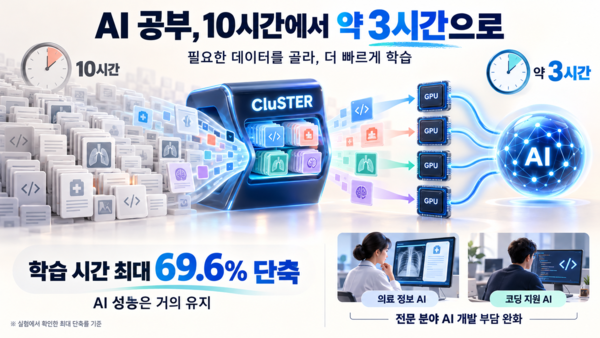
韓国科学技術院(KAIST)は11月2日、大規模言語モデル(LLM)の微調整にかかる学習時間を最大69.6%削減できる技術「CluSTER(クラスター)」を開発したと発表した。学習への寄与が近いデータを選別して複数のGPUに振り分けることで、全データの約31%だけを使ってもモデル性能をほぼ維持できたとしている。
この技術は、イ・ジェギル電算学部教授の研究チームが開発した。LLMの微調整では、コーディングや医療など特定分野のデータを追加学習させて性能を高めるのが一般的だが、複数のGPUでデータを分散処理する過程で、学習への寄与が似通ったデータを繰り返し処理してしまい、計算量のわりに学習効率が上がりにくいという課題があった。
研究チームは、各データがAI学習に与える影響を分析し、寄与の近いデータ同士をグループ化。その上で各グループから必要なデータを選び、複数のGPUに均等に配分する手法を採用した。これにより、重複を抑えながら多様な情報を学習に取り込めるようにした。
検証では、コーディング分野と医療分野の3種類のデータを用い、約70億パラメータと約130億パラメータ規模のLLMを微調整した。8つの評価指標で性能を確認した結果、全データの約31%のみを活用しても性能をほぼ維持しながら、学習時間を最大69.6%削減できた。従来約10時間を要した学習を、約3時間に短縮できる水準だという。
実験は4基のGPUを用いた環境を中心に実施し、8基のGPUを使う環境でも従来手法を上回る性能を確認した。
イ・ジェギル教授は「AI学習の効率を高めるには、GPUを増やすだけでなく、どのデータを学習に使うかを賢く選ぶことも重要だ」とコメント。「今回の研究は、既存のGPU資源をより効率的に活用し、大規模AIモデルの学習負荷を軽減できる点に意義がある」と述べた。
筆頭著者は、KAIST電算学部博士課程のキム・ヒョンジン氏。研究成果は10月、自然言語処理分野の国際学会「EMNLP 2026」で発表された。
 Jin-ho Lee
jhlee26@d-today.co.kr