
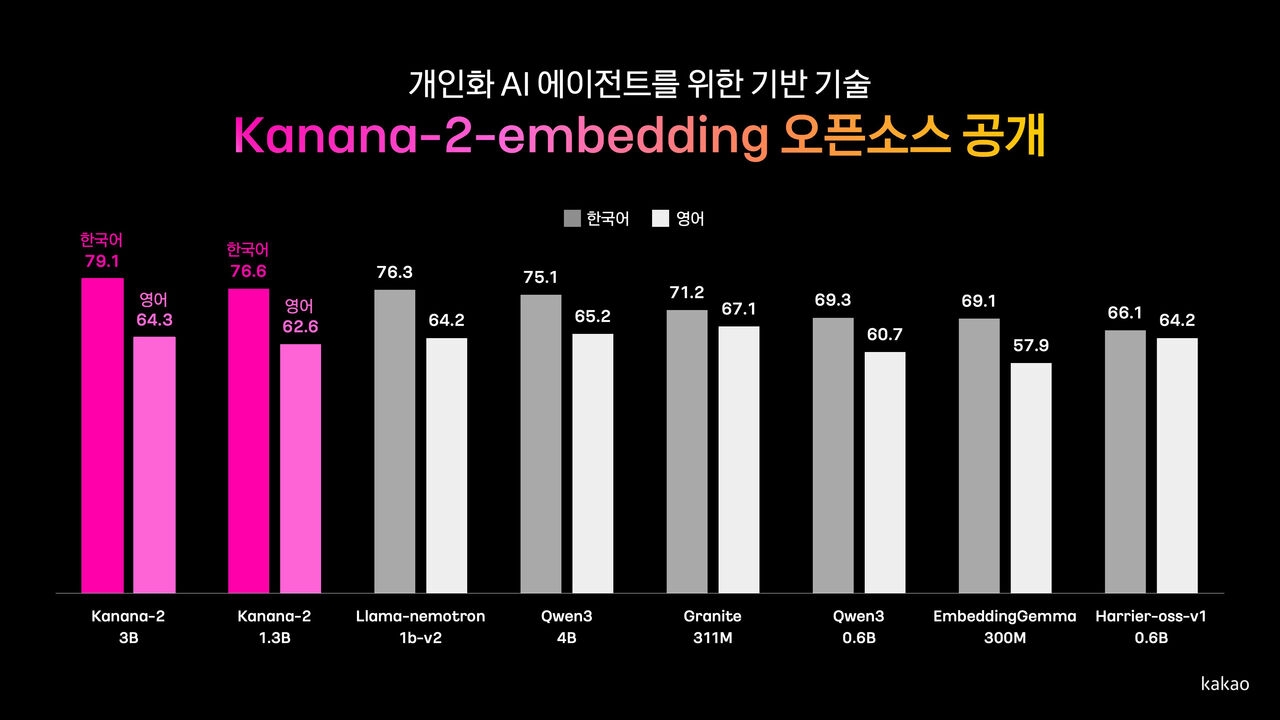
Kakaoは29日、パーソナライズドAIエージェントや意味検索に活用できる埋め込みモデル「Kanana-2 Embedding」2モデルをHugging Faceで公開したと発表した。30億パラメータの「Kanana-2-3b-Embedding」と13億パラメータの「Kanana-2-1.3b-Embedding」で、研究・開発に加え商用利用にも対応する。
埋め込みモデルは、テキストの意味を数値ベクトルに変換し、関連情報の検索に用いる技術だ。単語が完全に一致しなくても意味の近い情報を探せるため、AIエージェントによる過去情報の検索や意味検索などで活用される。
Kakaoは、自社の小型言語モデル(SLM)「Kanana-2-SLM」の言語理解能力をベースに、情報検索向けの学習を施して30億モデルを開発した。さらに、大規模モデルの知識を小型モデルに移す知識蒸留を適用し、13億モデルも構築した。
両モデルには、埋め込みベクトルの次元を調整できる「MRL(Matryoshka Representation Learning)」も適用した。開発者は利用環境に応じて、検索性能、保存容量、処理速度のバランスを見ながらベクトルサイズを選択できる。
Kakaoによると、公開したモデルは「Llama-Nemotron-Embed-1b-v2」や「Qwen3-Embedding-4B」と比較した社内評価で、韓国語性能が最も高かった。英語性能は同等水準で、「Qwen3-Embedding-4B」と比べて推論効率にも優れるとしている。
従来のKanana埋め込みモデルと比べても、検索性能を高めるとともに、メモリ使用量と推論速度の面で効率を改善したという。
今回の2モデルには「Kanana Open License」を適用した。ライセンス条件に基づき、研究・開発用途に加え商用利用も可能としている。
Kakaoは今後、より大規模な言語モデルを活用した埋め込み学習と知識蒸留の研究を続け、検索性能と運用効率のさらなる改善を目指す方針だ。
Kakaoのノ・ビョンソク氏(Unified Foundation Modelリーダー)は「研究者や開発者が、韓国語に強みを持つ埋め込み技術をさまざまなサービスで活用できるよう支援していく。今後も検索性能と効率の両立に向けた研究を続ける」とコメントした。
 Hojeong Lee
lhj@d-today.co.kr