
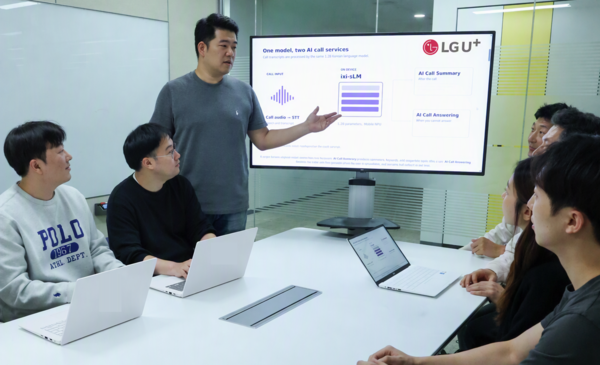
LG U+は10月29日、AIのトークン最適化技術に関する論文2本が、国際学会「NeurIPS 2026」のオンデバイス・インテリジェンス・ワークショップに採択されたと発表した。端末内で小型言語モデルを高速に動作させる技術で、処理速度を従来比約4.5倍に高め、バッテリー消費を約77%削減したとしている。
NeurIPSはICML、ICLRと並ぶ主要なAI学会の一つ。2026年は12月6日から12日まで、オーストラリア・シドニーで開催される予定だ。今回採択された研究は、スマートフォンの限られたメモリ容量や電力条件でも、小型言語モデル(sLM)を効率よく動作・学習させる技術を扱う。
同社は、通話サービスへの活用を想定したsLMを開発し、モデルの軽量化と推論高速化技術を適用した。クラウドAI並みの性能を維持しながら、スマートフォンの計算資源と消費電力を抑えたという。その結果、従来方式に比べて処理速度は約4.5倍に向上し、バッテリー消費は約77%減った。
あわせて、個人データを外部サーバーに送らず、スマートフォンの端末内でAIを追加学習させる技術も開発した。学習に必要な計算量とメモリ使用量を抑えることで、端末内での追加学習を可能にした。実際のスマートフォン環境で検証した結果、サーバー側で学習したモデルと同程度の精度を確認したとしている。
LG U+は、今回の研究成果を自社のAIサービスへ適用することを検討している。スマートフォン環境で確立した最適化技術をサーバーGPU環境にも広げ、AIサービスの処理速度と運用効率の向上につなげる考えだ。
イ・サンヨプ最高技術責任者(CTO)は「NeurIPSでの論文採択は、制約のある環境でもAIを迅速かつ効率的に実行・学習させる研究成果が認められた結果だ」とコメントした。その上で「関連技術を実際のサービスに適用し、今後は研究の対象をサーバー環境にも広げていく」と述べた。
 Jin-ho Lee
jhlee26@d-today.co.kr