
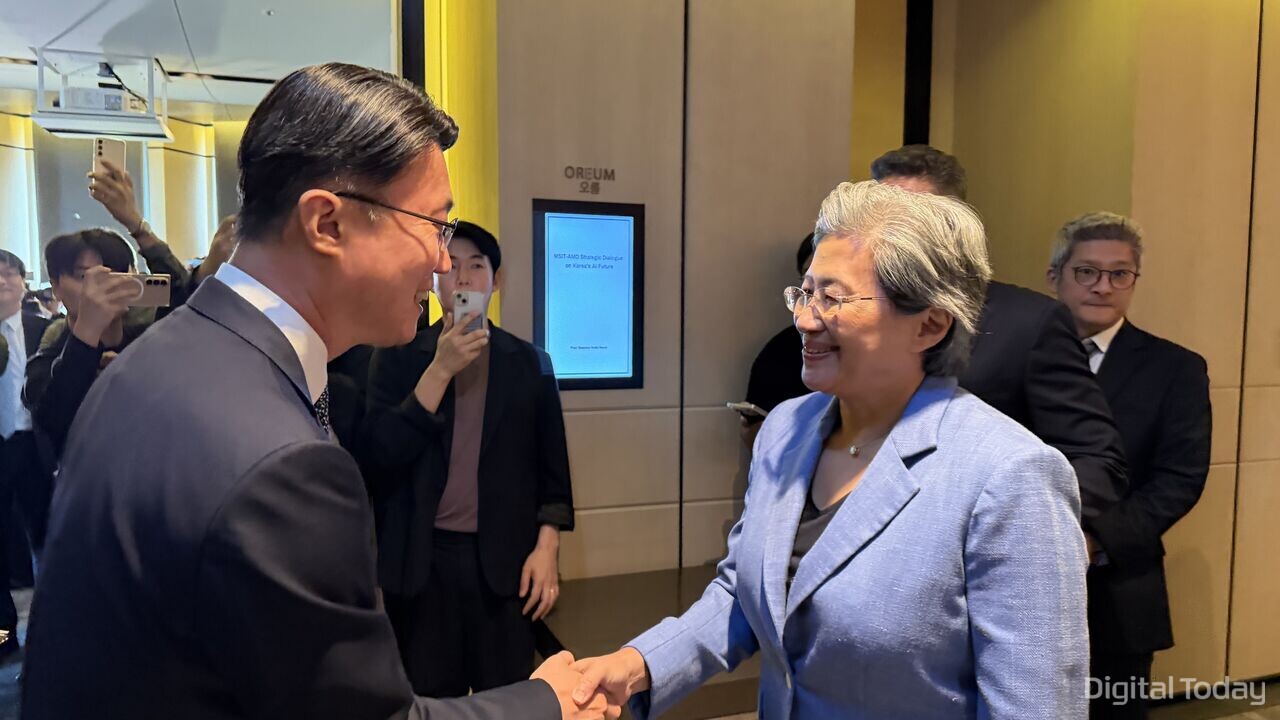
AMDのリサ・スー会長が韓国のAI半導体企業と会合し、オープンエコシステムを軸にした協業拡大に向けて動き出した。Nvidia製GPUに偏りがちなAIインフラを、AMDのGPUや国産NPU(ニューラル・プロセッシング・ユニット)などへ広げ、将来的にはモデル、半導体、ソフトウェア、インフラを含む「フルスタック・ソブリンAI」へつなげられるかが焦点となる。
韓国の科学技術情報通信部とAMDは7日、ソウル市鍾路区のフォーシーズンズホテルで「AI半導体・スタートアップ・ラウンドテーブル」を開催し、韓国のAI企業と異種コンピューティングエコシステムの構築に向けた協力策を議論した。
会合にはFuriosaAI、HyperAccel、DeepX、Mobilint、Mangoboost、Panmnesia、Dnotitia、Moreh、NotaAI、RBLN、Fadu、Elice Group、Upstageの13社が参加した。NPU、ソフトウェア、クラウド、AIモデルなど、AIインフラ全般を担う韓国企業が顔をそろえた。
リュ・ジェミョン科学技術情報通信部第2次官は冒頭、「AIの重心が学習から推論へ移る中、単一の半導体への依存ではなく、サービスの種類や用途に応じて多様な計算資源を柔軟に使い分ける異種AIコンピューティングの重要性が高まっている」と述べた。
そのうえで、AMDがオープンソースと標準に基づくオープンなコンピューティングエコシステムを拡大していることから、韓国企業にとっても新たな協業機会が広がる可能性があると期待を示した。
科学技術情報通信部とAMDは、AMDのCPU・GPUと国産AI半導体を組み合わせた異種コンピューティング基盤を構築し、グローバル市場でも活用できる大規模リファレンスへ発展させる案についても協議した。
スー会長も、AMDの中核原則としてオープンエコシステムと協業を改めて強調した。
同氏は「この6カ月でAI分野は大きく進展した。AMDは一貫してオープンエコシステムと協業を重視してきた」と説明。「この場にいる企業の一部とはすでに協業しており、きょうの対話を通じてさらに協力を深めたい」と述べた。
さらに、「AIのフロンティアを前進させ、世界でのAI導入を広げるにはオープンエコシステムが不可欠だと考えている」と語り、韓国スタートアップの技術力とAMDが支援できる協力領域を見極めたい考えを示した。
◆Nvidia依存から異種コンピューティングへ
業界では、AMDによる韓国企業との協力拡大が、単にNvidia製GPUをAMD製GPUに置き換える段階にとどまらないとの見方が出ている。
AIサービスが学習中心から大規模推論へ急速に移る中、すべての演算を単一の高性能GPUで処理するよりも、ワークロードごとにGPUやNPUなど異なるアクセラレータを組み合わせる方式の重要性が高まっているためだ。
国産NPU企業にとっても、新たな市場が開ける可能性がある。韓国のAI半導体企業の多くは、超大規模モデルの事前学習よりも推論に軸足を置いてきたが、エージェントAIの拡大と推論量の増加によって、推論インフラそのものの大規模化が進み、活用領域も広がりつつあるという。
RBLNのシン・ジョンギュ代表は会合に先立ち記者団に対し、「AI市場の拡大スピードは、NvidiaやAMDのような企業がすべてをカバーできる速度をはるかに上回っている」と指摘した。「各社が選択と集中を進めるほど、市場には空白が生まれざるを得ない」との見方も示した。
高性能GPUが超大型・高付加価値の市場へシフトするなか、既存データセンターで使われてきたGPUの置き換え需要や、電力効率が重視される推論市場が、国産NPUにとって商機になり得るという説明だ。
シン代表は「H100のような既存GPUが使われていた領域でも、来年から置き換え需要が発生する」とし、「その水準の性能を埋められるNPU企業には明確な機会が生まれる」と述べた。コーディング、エージェントAI、中規模モデルのオーケストレーションなど用途が多様化していることに加え、データセキュリティを理由にエッジインフラの整備を進める企業が増えている点も、国産NPU需要を押し上げる要因になるとみている。
◆推論から学習へ 「フルスタック・ソブリンAI」は実現できるか
焦点は、国産AI半導体の役割をどこまで広げられるかにある。
現時点で韓国企業が商用化したNPUの多くは推論向けに集中している。超大規模AIモデルの事前学習は事実上、Nvidia中心のGPUエコシステムに依存しており、モデルから演算インフラまでを含む「フルスタック・ソブリンAI」を実現するには、学習用チップという空白を埋める必要がある。
事前学習は大量データを用いてAIモデルの基礎能力をゼロから作り込む工程で、膨大な計算資源を要する。一方、追加学習は事前学習済みモデルをファインチューニングや強化学習(RL)などで特定目的に合わせて高度化する工程で、必要な計算規模は比較的小さい。国産NPUが推論を超えて学習領域へ入る現実的な出発点として位置付けられている。
業界では、まず推論と追加学習で国産NPUの活用を広げ、将来的に事前学習まで段階的に拡張していく案が取り沙汰されている。
FuriosaAIのペク・ジュンホ代表は「韓国は半導体をフルスタックで手がけられる、世界でも数少ない国の一つだ」と述べ、「根本的には十分可能だと考えている」と話した。足元ではデータセンターにおける推論市場の比重が大きく、まずは推論に注力しているが、技術的には将来的に事前学習領域まで拡張できるとの認識を示した格好だ。
同氏はまた、大規模クラスターを活用する推論の需要が増えることで、推論向けNPUで蓄積した技術やインフラが、将来の学習領域への拡張基盤になり得るとの見方も示した。
さらに、政府が来年度に4兆7000億ウォンを投じて進めるフロンティアAIモデル開発事業を、国産NPUのテストベッドとして活用すべきだと提案した。初期導入時の試行錯誤を減らし、実際のAIモデル開発に基づくリファレンスを確保できる機会を政府がつくるべきだとの主張だ。
ペク代表は、国産NPUで初めて学習を試みる際には一定の試行錯誤が避けられないとして、政府がテストベッドの役割を担う必要性を強調した。GPU中心でモデル開発を進めつつ、追加学習から国産NPUの活用を始め、成果に応じて事前学習へ段階的に広げる構想を描く。
◆韓国政府も「フルスタック」へ 国産NPUの大規模リファレンス整備
韓国政府も、国産NPUを実際のAIインフラで活用できるよう、来年から大規模リファレンスの整備に乗り出す。従来のチップ単位の導入・実証から踏み込み、CPU、GPU、NPU、CXL(Compute Express Link)、ソフトウェアを一体のシステムとして束ね、性能と相互運用性を検証する方針だ。
科学技術情報通信部のイ・ドギュ情報通信政策室長は同日の記者向け説明で、「これまでは国産NPUをチップ単位で供給するケースが多く、グローバル展開に限界があった」と指摘。そのうえで「来年はCPU、GPU、CXL、ソフトウェアまで含め、フルスタックとして適切に検証できる大規模リファレンス整備事業を計画している」と説明した。
事業は単一テーマではなく複数テーマで公募し、技術やサービスに応じて企業がコンソーシアムを組んで参加する方式で進める予定だ。
フロンティアAIモデル開発事業でも、国産NPU活用の余地は残されている。国産NPUを追加学習や推論に用いてリファレンスを確保する案について、イ室長は「省庁レベルで当然考慮しながら進めていると理解している」と述べた。具体的な活用方法や比重は、現時点では決まっていないという。
AMDとの協力も、こうした方向性と重なる。韓国政府はAMDのCPU・GPUと国産NPUを組み合わせ、コストと電力効率を高めると同時に、それを支えるソフトウェアエコシステムの整備も進める考えだ。
イ室長は、CPU、GPU、NPUを最適に組み合わせて最小コストで高性能を引き出し、それを支えるソフトウェア環境を整えることが重要だと強調した。韓国企業がAMDのオープンエコシステムに参加し、グローバルパートナーへ成長できるよう支援するのが政府の基本方針だとしている。
 Seulgi Son
sageson@d-today.co.kr