
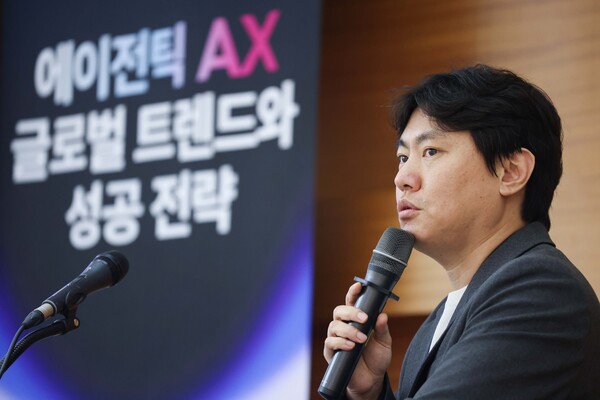
同じAIモデルを導入しても、企業によってAIエージェントの成果に差が出る。AI・データ専門企業Encoreのキム・ギドン氏は29日、デジタルトゥデイがソウルのCOEXで開催した「デジタルインサイト2026」で講演し、その差を生む要因はモデル性能ではなく、AIが活用できるよう整備された「AIレディデータ」の有無にあると説明した。
キム氏は、AIエージェントが企業内データを適切に扱うには、データそのものだけでなく、その意味や他のデータとのつながりまで事前に整理しておく必要があると強調した。
多くの企業は、先進的なAIモデルやプラットフォームを導入し、概念実証(PoC)やデモでは一定の成果を上げている。ただ、本番環境に移行すると、AIエージェントが想定通りに機能しないケースが少なくないという。
こうした問題は、既存データとAIを実運用で接続する段階で表面化しやすい。デモでは動いていたエージェントでも、本番では既存のデータ構造がAIエージェント向けに最適化されておらず、十分に機能しないケースが多いとした。
背景には、企業のレガシーなデータ構造がある。セキュリティや運用上の理由から、テーブル名が判別しにくい形で付けられていたり、カラムの説明が不足していたりする例は珍しくない。組織内でしか通用しない略語が多用されることもある。さらに、関連情報を設定するとシステム性能に影響が出るとして、テーブル間の接続関係を明示しないまま運用されるケースもあるという。
システムが異なる場合は、接続情報自体が存在しないこともある。例えば、製造実行システムの投入データとERPの出荷データがどう結び付くのかが、担当者の知識や設計文書にしか残っていない場合があると説明した。
キム氏は「データに説明を付け、関係を定義すればよいと分かっていないから手を付けないのではない。レガシーなデータ構造がそれを難しくしている」と指摘。「存在しない情報をAIモデルが作り出すことはできない。AIが使うデータに必要な情報は、あらかじめ整備しておくべきだ」と述べた。
Encoreは、こうした課題を踏まえて「AIレディデータ」の定義を見直した。キム氏は「AIレディデータは、単にきれいで品質の高いデータではない。それも条件の一つにすぎない」とした上で、「重要なのは、AIが理解し、信頼できるデータであることだ」と強調した。
同氏は、AIレディデータの条件として3点を挙げた。第1は「識別可能性」で、エージェントがデータを探すには、そのデータが何を示すのか識別できなければならない。第2は「関係探索性」で、データ同士がどうつながるのかを把握できる必要がある。第3は「文脈制御」で、エージェントが参照できるデータ範囲を権限に応じて管理しなければならないという。キム氏は「誰がどこまで閲覧できるデータなのかを管理してこそ、エージェントを安全に運用できる」と話した。
また、AIレディデータは従来のメタデータとも異なるという。データベース管理向けのメタデータは、テーブルやカラムの有無、標準順守、変更時の影響範囲といった構造情報を扱う。一方で、AIエージェントが必要とするのは、データが何を意味し、どう使うべきかという情報だとした。
キム氏は「エージェントが登場する前は、こうした情報はそこまで重要ではなかった。担当者が経験で把握していたり、文書化されていれば足りた」とし、「AIレディデータは既存メタデータを置き換えるものではなく、その上にデータの意味や接続情報を追加する考え方だ」と説明した。
Encoreはこの仕組みを「文脈地図」として実装している。文脈地図では、データの説明、業務上の呼称(ラベル)、利用目的、関係情報、アクセス権限の5項目を管理する。AIエージェントはベクトル検索によって業務用語と意味の近いデータを探し、グラフ検索によってデータ間の接続関係をたどる。テーブル名から推測するのではなく、あらかじめ定義された意味と関係に基づいて回答する仕組みだ。
キム氏は、「顧客の好みの品目」に関するデータが、状況によっては機微情報になり得る例を挙げた。「エージェントごとにルールを組み込む方式では、10のエージェントがあれば10すべてを修正しなければならない。文脈地図なら1カ所を直せば済み、定義を修正してもエージェント自体を直す必要はない」と述べた。
もっとも、必要なデータを見つけられても、それだけで答えを返せるとは限らない。例えば、特定の資材トラブルがどの品目まで影響したかを問われた場合、文脈地図は関連する4つのテーブルを提示できても、それらをどの順序と条件で結合すべきかまでは示せないという。
この課題への対応策として、キム氏は「セマンティックモデル」を示した。セマンティックモデルは、「顧客」や「注文」といった業務用語の意味を統一し、それぞれに該当するデータをひも付けるための基準となる。このモデルを基に、一方ではメタデータに意味を付与したメタデータグラフ、すなわち文脈地図を構築し、もう一方では実データを業務フローに沿ってつなぐインスタンスグラフを構築するという。
キム氏は「データを探すときにはメタデータグラフを使い、答えを生成するときにはインスタンスグラフを使う。両者は同じセマンティックモデルから生まれる」と説明した。その上で「AIモデルや技術は今後も進化していく。ただ、エージェントが何を活用し、何を判断できるかは、事前にどこまでデータを整備できているかに左右される」と述べた。
 Chi-gyu Hwang
delight@d-today.co.kr