
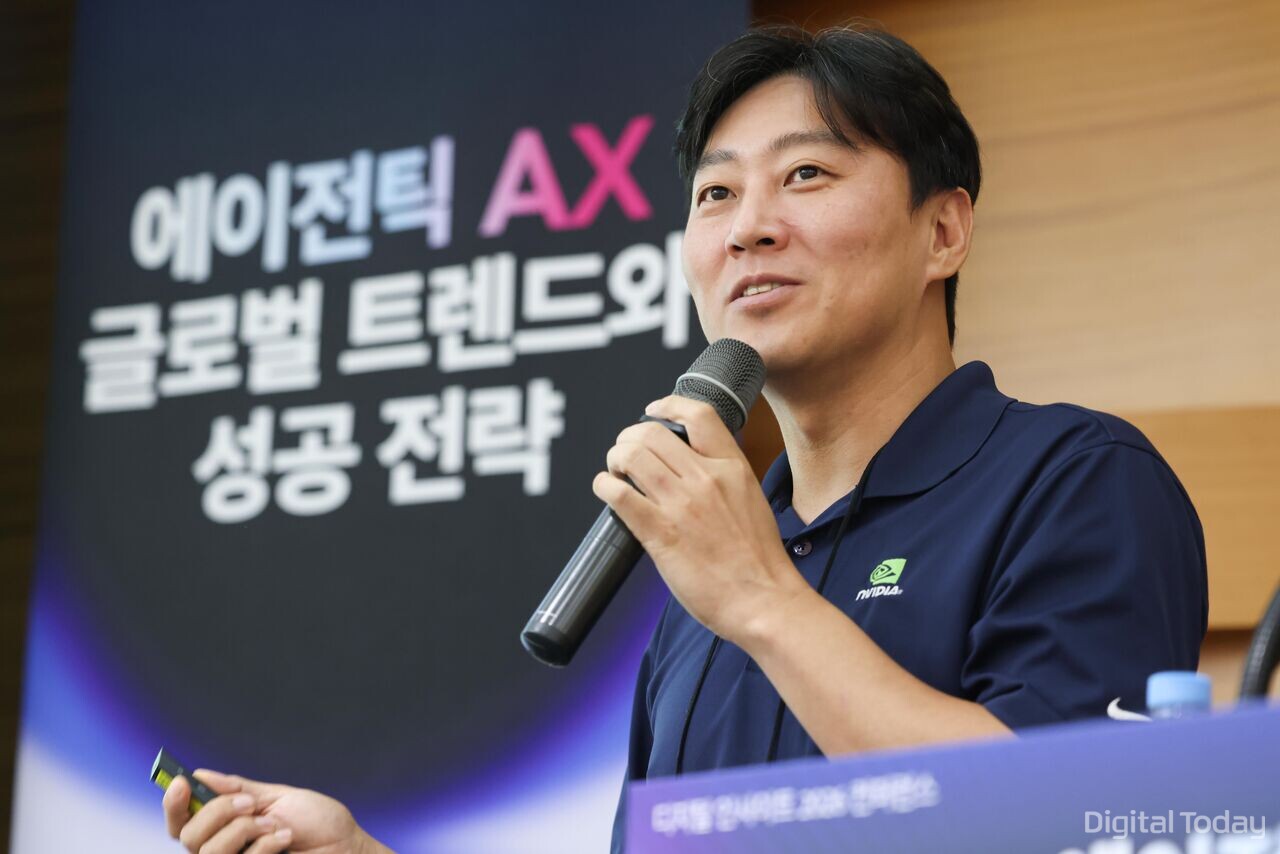
NVIDIAが定義する「真のエージェント」は、単に人の問いに応答する対話型AIではない。業務を与えれば、12時間以上にわたって自律的に作業を続けるAIを指す。NVIDIA Koreaのキム・ソヌク常務が29日、DigitalToday主催の「Digital Insight 2026」でこうした見解を示した。
会場はソウル市江南区のCOEX。キム常務は、エージェントAIについて「仕事を与えれば、長時間にわたって自律的に動き続ける」と説明した。その上で、真のエージェントには単一モデルだけでなく、複数のツールや構成要素を連携させるオーケストレーションが不可欠だと述べた。
こうしたエージェントを実運用するため、企業はすでに計算資源の確保に動いているという。キム常務は、計算資源が足りず、利用に関する問い合わせが非常に多いとし、企業によるエージェントAI活用が広がっているとの認識を示した。
キム常務は、エージェントの基本構成を「LLMにハーネスを組み合わせた形」と説明した。LLMが言語理解を担う中核であるのに対し、ハーネスはその中核を制御し、実際の処理へつなぐ役割を果たす。ユーザーの履歴を保持しながらプロンプトを整え、ファイルやコンピュータ、各種ツールと連携して、人の代わりに行動する仕組みだ。中核となるLLMは、NVIDIA製やGoogle製など複数のモデルから、計算環境に応じて選択するという。
このハーネスが主に動作するのはCPUだ。キム常務は「LLMはGPUで動かし、ハーネスは大半がCPUで動く。だからCPUが非常に重要になった」と述べた。エージェントの学習方式が変化していることも、CPUの役割を押し上げているという。
以前はLLMそのもののトレーニングが中心だったが、現在はエージェント全体の学習へと軸足が移っている。キム常務によれば、エージェントの作業結果に対するフィードバックを受けながら数万回単位で反復するプロセスをCPUが担う。このため、NVIDIAはCPUラックを別途用意しているという。現在はArmベースのCPU「ベラ」を開発・活用しているとした。
一方、CPUだけでは負荷の大きいストレージのセキュリティ処理やデータ加工は、DPU(Data Processing Unit)が担う。DPUは、従来CPUが処理していたデータ処理の一部を切り出して受け持つためにNVIDIAが設計したチップだ。高速なネットワークI/Oを担い、データの解析や処理を実行した上で、GPUやCPUへ効率的に転送する。
エージェントが作業を継続する上で、メモリも重要な基盤となる。エージェントは、与えられた任務やこれまでの履歴をメモリ上に保持しながら処理を進める。キム常務は、人間が幼少期から積み重ねた記憶を基に判断するように、エージェントでもメモリが極めて重要だと説明した。
もっとも、チップをそろえるだけでエージェントが完成するわけではない。キム常務によると、現時点ではモデルだけを手掛ける企業と、ハーネスだけを手掛ける企業に分かれている。このためNVIDIAは、独自LLM「ネモトロン」を起点に、データ高速化ライブラリや安全機構まで含めたエージェント向けツールキットを提供し、各要素を組み合わせて構築できるようにしている。キム常務は「これを使ってもよいし、別のモデルを使ってもよい。得意な部分だけ差し替えれば、異なる結果が得られる」と述べた。
NVIDIAは、エージェントを単なるモデルの問題ではなく、インフラの課題として捉えている。キム常務は、CPU、GPU、ストレージサーバを一体のインフラとして束ねることで、エージェントを動かせると説明した。さらに、そのインフラを支えるのは電力だとし、「どれだけの電力を投入し、どれだけのトークンを生み出したかが収益につながる」と語った。
NVIDIAが次の段階として見据えるのはロボットだ。キム常務は、ロボットは移動しながら動作する分、エージェントにかかる負荷がはるかに大きいと指摘し、「さらに複雑なシステムを作らなければならない」と述べた。
 Daegeon Seok
d2dg@d-today.co.kr