
Qualcommは、スマートフォン向け新プラットフォーム「Snapdragon 8 Elite(第6世代)」で、300億パラメータ級のAIモデルを端末上で動作させる技術を打ち出した。NPU内メモリの拡張に加え、MoEやUFS 5.0を組み合わせることで、スマートフォンのメモリ制約を抑えつつ大規模モデルを扱えるようにした。こうしたデータ配置の考え方はCPU側にも広げている。
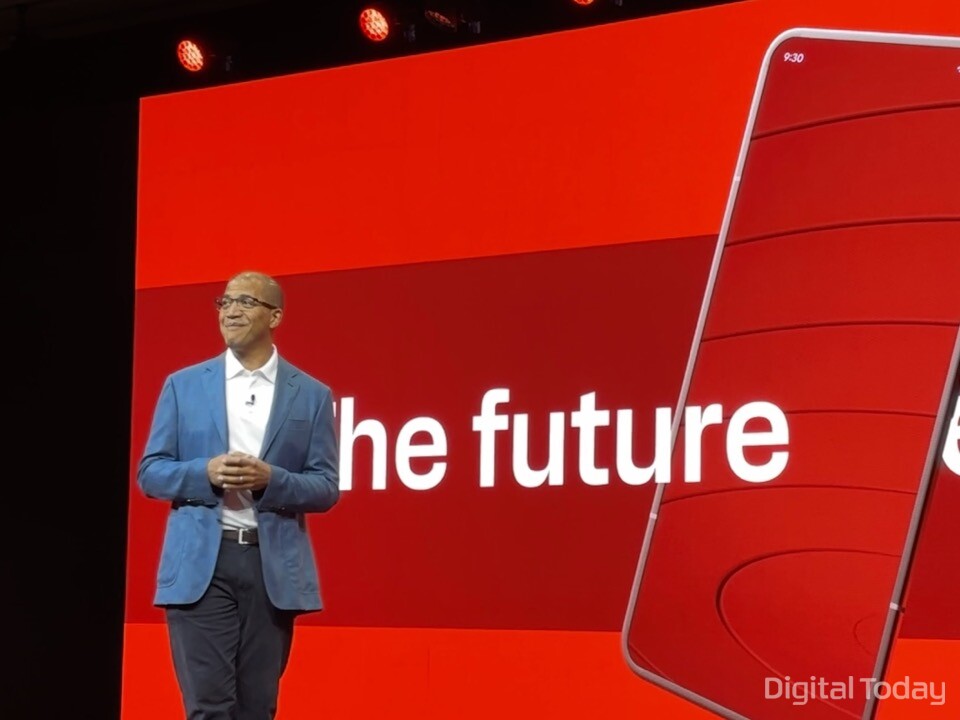
クリス・パトリック上級副社長兼モバイル・ハンドセット本部長は9月22日(現地時間)、「Snapdragon Summit 2026」の基調講演で、「AIエージェントが高度になるほど、より強い推論能力と豊富なコンテキストを備えた大規模モデルへのアクセスが必要になる」と述べた。その上で、ユーザーの代わりにタスクを処理するには、多段階の推論やコンテキスト探索、ツール呼び出しが欠かせず、モデル規模とコンテキスト長の両方を拡大する必要があると説明した。
同サミットで公開したSnapdragon 8 Elite(第6世代)は、300億パラメータ級のAIモデルをスマートフォン内で動作させる。必要な部分だけをフラッシュストレージから読み出し、使用頻度の高いデータはNPU内に保持する仕組みで、Hexagon NPUの共有メモリは50%拡大した。
Qualcommは事前説明で、「業界全体のメモリ制約を踏まえ、インテリジェンスをプロセッサ近くに置くための技術革新を進めている」としていた。今回示した設計では、NPU内メモリを増やし、共有メモリにコンテキストやKVキャッシュをより多く格納する。KVキャッシュは、過去に処理した内容を再計算せずに済ませるための一時メモリを指す。
これにより、データがNPU内にとどまる時間が長くなり、外部DDRメモリとの往復を減らして遅延を抑えられるという。新たに導入したエレメント・アクセラレーターは、最大3万2000トークンのコンテキストウィンドウに対応する。一部モデルでは、プリフィル性能が最大80%向上したとしている。
NPU外では、MoE構造とフラッシュストレージを組み合わせる。MoEは、複数の専門領域に分かれたモデルのうち、要求に関連する部分だけを動作させる仕組みで、Denseモデルに比べて演算量やメモリ帯域の負荷を抑えやすい。このモデルでは、トークン生成の各段階で全パラメータのうち約30億個のみを有効化し、UFS 5.0と独自のインテリジェント・フラッシュメモリ管理システムを組み合わせることで、フラッシュストレージから直接読み出して動作させる方式を採るという。
基調講演では、このモデル上で動作するAIエージェントのデモも披露した。招待状から日付やフライト、場所を把握し、3日分の行程を自動で作成する内容で、初日は歓迎晩餐に合わせた移動とチェックイン、2日目は空き時間を使ったミーティング、3日目はキーノートとブースでのレセプションを中心に予定を組んだ。Qualcommは、MoE構造によって理解、推論、実行の各段階で異なる専門家を有効化すると説明した。
Qualcommによると、前世代のアーキテクチャでは300億パラメータ超のMoEモデルは動作できなかった。今回はNPU構造の改善に加え、エレメント・アクセラレーターの追加とNPU内メモリの拡張を実施した。データをNPU内、DRAM、フラッシュストレージに分散配置する構成を示し、スマートフォンでも応答性とプライバシー保護を両立した生成AIの実現につなげる考えだ。
こうしたデータを演算器の近くに置く設計思想は、CPUにも適用した。ゲームや動画編集、マルチタスクなど、大量のデータを高速にやり取りする処理を支援する狙いがある。
パトリック上級副社長は、「新しいOryon CPUのFlexCacheは、8コア全体でL2キャッシュを共有プールとして使い、必要な場所にリソースを動的に割り当てる」と説明した。その上で、「AIエージェントは推論やコンテキスト探索、ツール呼び出しを行いながら、処理をCPU間で継続的に移していく。FlexCacheはその切り替えを高速化する」と述べた。
 Suk Dae-geon
d2dg@d-today.co.kr