
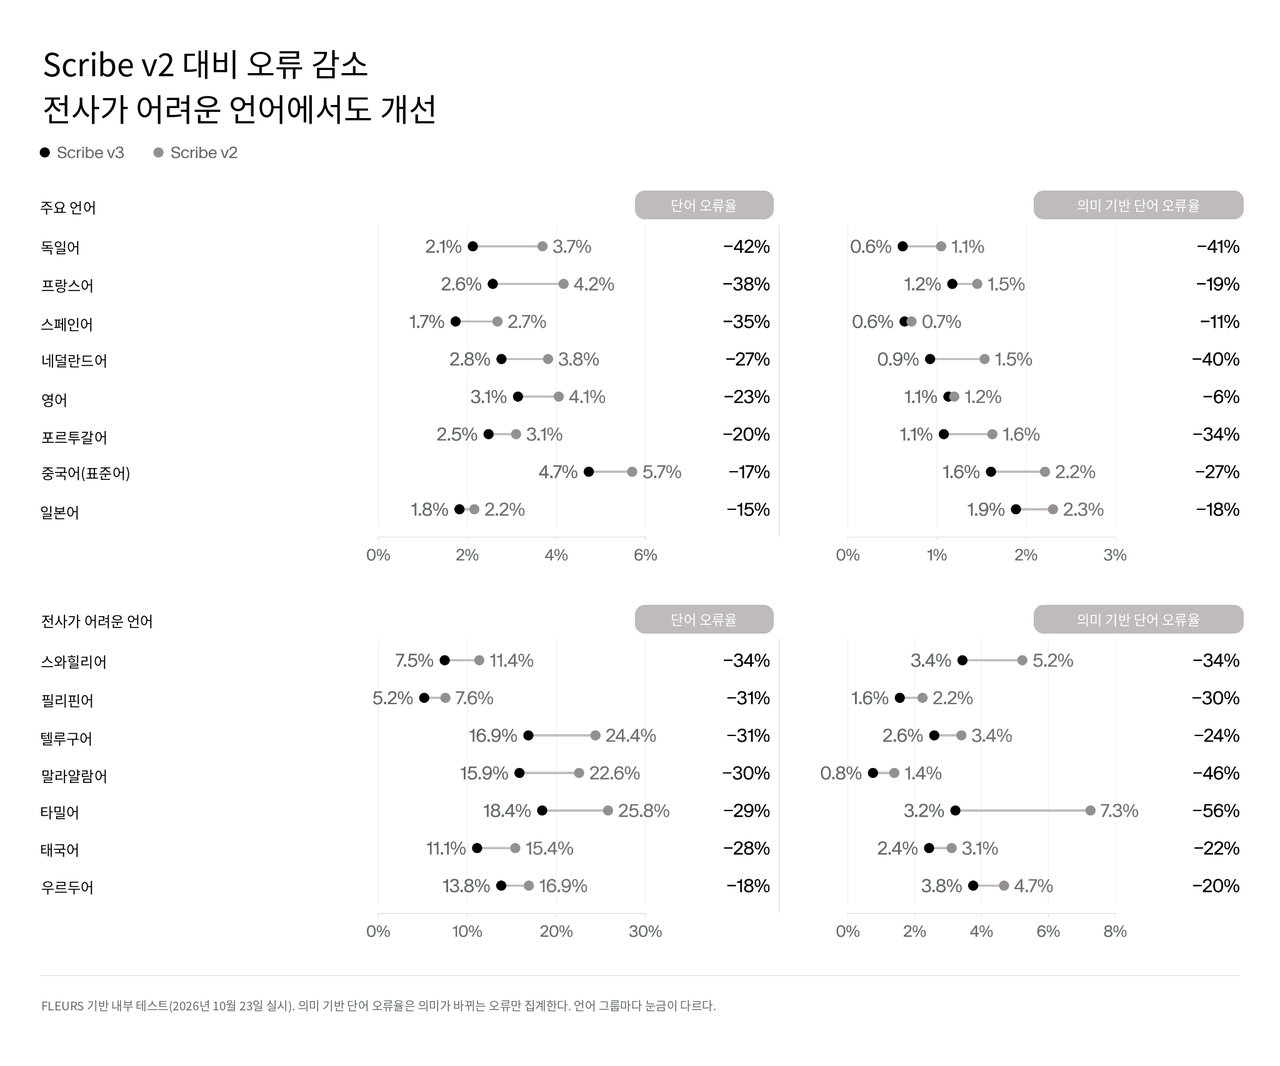
ElevenLabsは19日、音声認識(STT:Speech to Text)モデル「Scribe v3」と「Scribe v3 Live」を発表した。録音済み音声向けの「Scribe v3」は前世代比で単語誤り率を27%低減し、リアルタイム音声向けの「Scribe v3 Live」は「Scribe v2 Realtime」と比べて誤り率を43%減らしたという。
同社によると、Scribe v3は録音済み音声の文字起こし向けモデルで、前モデルの「Scribe v2」から認識精度を高めた。
話者を識別する話者分離(Diarization)でも、同社の社内評価では過去モデルの中で最も低い誤り率を記録したとしている。
一方、Scribe v3 Liveはリアルタイム音声向けモデル。「Scribe v2 Realtime」比で認識誤りを43%削減したほか、話者分離にも対応した。あわせて、発話ターンの検知(Turn Detection)性能も改善したと説明している。
著者について
 Chi-gyu Hwang
delight@d-today.co.kr
キーワード
#ElevenLabs #音声認識 #STT #Scribe v3 #Scribe v3 Live
