
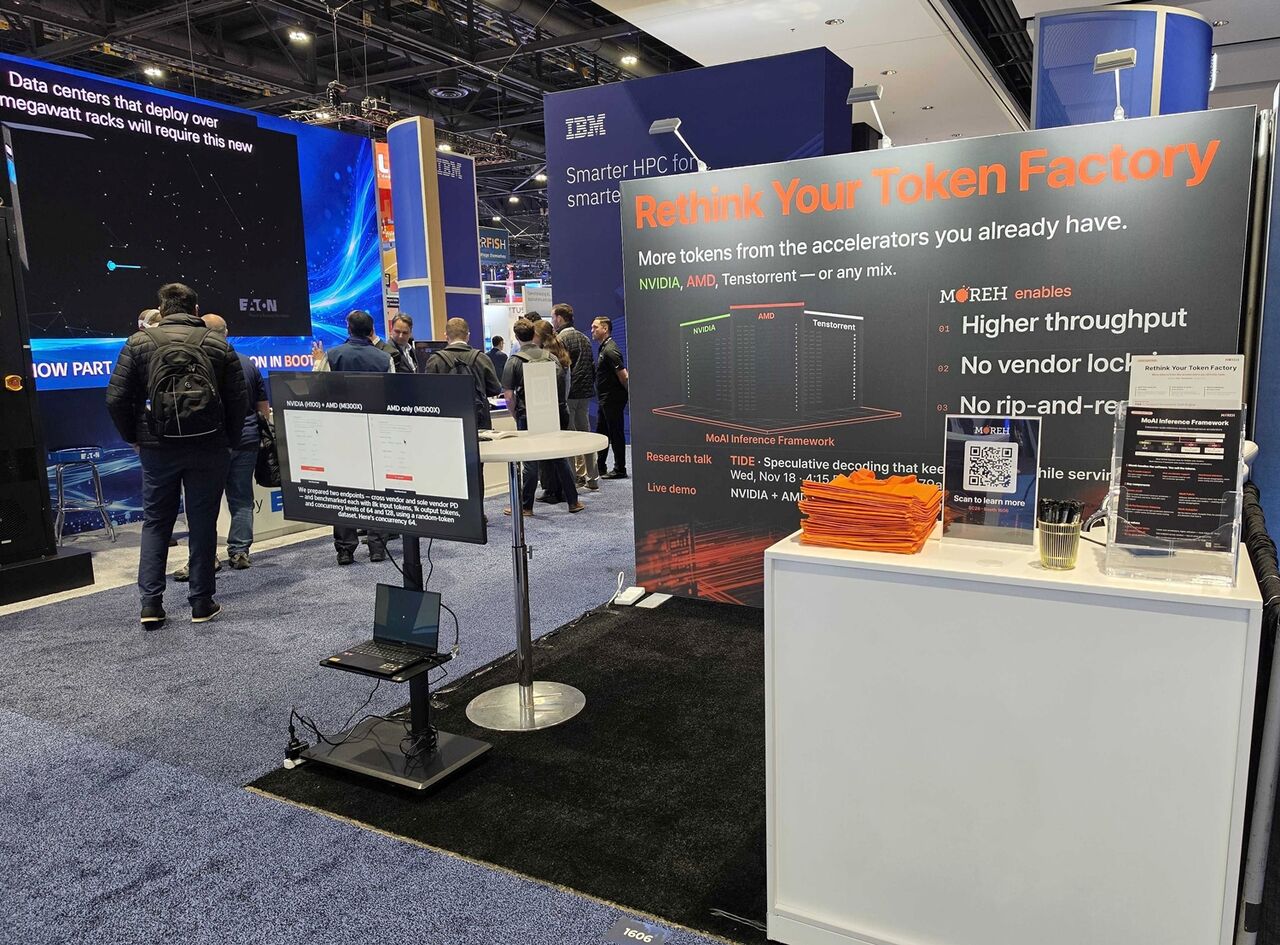
AIインフラソリューションを手掛けるMoreは11月20日、米シカゴで開催された「Supercomputing 2026(SC26)」で、大規模言語モデル(LLM)の推論効率を高めるフレームワーク「TIDE」を発表した。
TIDEは、実運用のAI推論過程で生成されるデータを活用し、補助モデルを継続的に改善する技術。ユーザーの要求やワークロードが変化しても、推論システムがそれに応じて性能を自動最適化できる点を特徴とする。
中核技術は「推測デコーディング(Speculative Decoding)」だ。小規模な補助モデルが複数のトークンを先行して予測し、大規模モデルがそれをまとめて検証することで、回答生成を高速化する。
従来の推測デコーディングでは、実際のユーザー要求と補助モデルの学習パターンにずれがあると、予測精度が下がり、性能も低下しやすいという課題があった。これに対しTIDEは、大規模モデルが推論中に生成する内部情報を再利用し、補助モデルを段階的に学習させることで、この問題を改善したとしている。
さらに、補助モデルの予測精度と性能改善効果をリアルタイムで分析し、推測デコーディングの適用可否や追加学習の必要性を自動で判定する。不要な演算を抑えながら、変化するワークロードに対応できるよう設計した。
MoreがSC26で公表した研究結果によると、TIDEは推測デコーディングを使わない従来方式と比べ、AI推論のスループットを最大1.66倍に高めた。追加の学習データを別途用意せず、推論プロセスの内部情報を再利用することで、補助モデルの学習時間も従来のオンライン学習方式比で最大3.02倍短縮したという。
異種GPU構成でも効果を確認した。NVIDIA H100 GPUで大規模モデルを動かし、AMD Instinct MI250 GPUで補助モデルを学習させる環境では、同じGPUリソースをすべて推論処理に充てた場合と比べ、システム全体のスループットが最大1.22倍向上したとしている。
今回の研究は、MoreのAI推論プラットフォーム「MoAI Inference Framework」の開発過程で蓄積した技術を基に進めた。Moreは現在、NVIDIAやAMDのGPU、TenstorrentのAIチップなど、異なるアクセラレーター間で演算負荷を効率的に配分するインフラソフトウェア「Token Factory OS」の開発にも注力している。
チョ・ガンウォン代表は「AIインフラの競争力は、高性能GPUの確保だけで決まるものではない。限られたコンピューティングリソースで、どれだけ多くのAI演算を処理できるかが重要だ」と述べ、「多様なGPU環境でAI推論性能とリソース活用効率を高めるソフトウェア技術を継続的に開発していく」とコメントした。
 Seulgi Son
sageson@d-today.co.kr
キーワード
#More #TIDE #SC26 #LLM #大規模言語モデル #推測デコーディング #GPU
