
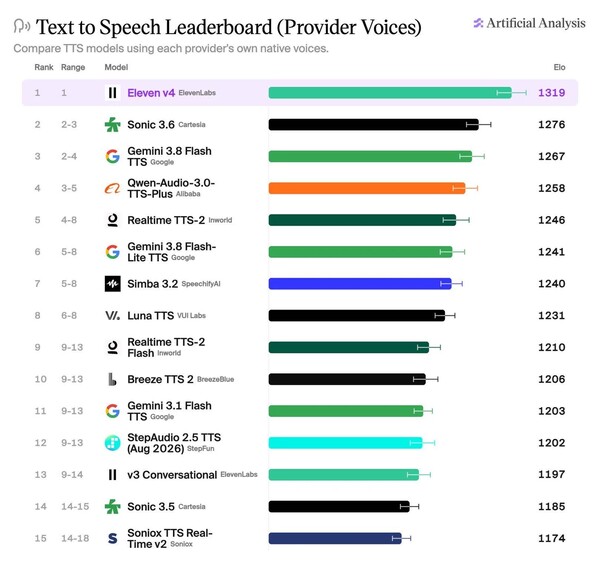
ElevenLabsは10月1日、次世代のテキスト読み上げ(TTS)モデル「Eleven v4」と、低遅延モデル「Eleven v4 Turbo」を発表した。
Eleven v4は、テキストのトーンや話速、話者の特徴、文脈を反映した音声生成に対応する。自然言語の指示やテキスト内のタグを使って、話し方や感情、音響効果を調整できる。
対応言語は、従来のv3の70言語から90超へ拡大した。新たな話者管理の仕組みを採用し、繰り返し生成しても話者ごとの声質を維持できるようにした。直前の発話を文脈として取り込み、複数話者の会話も生成できるよう設計したという。
同社によると、Eleven v4はAIモデル評価機関Artificial Analysisが9月に実施した「Provider Voice Arena」で首位を獲得した。
同時に公開したEleven v4 Turboは、リアルタイム音声AIエージェント向けに遅延を抑えたモデルだ。初回応答時の中間推論レイテンシーは平均100msで、同社の対話型エージェントプラットフォーム「ElevenAgents」と連携する。
両モデルは「ElevenCreative」「ElevenAgents」「ElevenAPI」を通じて利用できる。
共同創業者兼CEOのマティ・スタニシェフスキ氏は、「豊かな感情表現と文脈理解を基盤に、コンテンツ制作やAIエージェントで活用できるようにした」とコメントした。
著者について
 Seulgi Son
sageson@d-today.co.kr