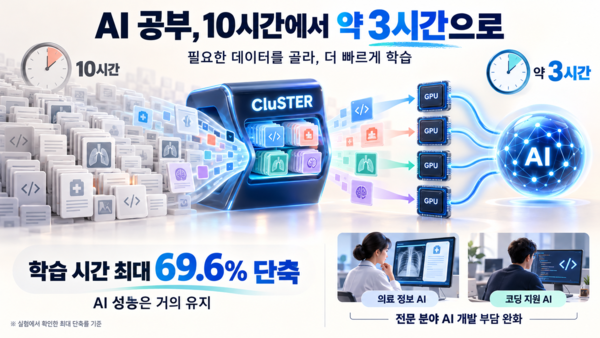
Viện Khoa học và Công nghệ Tiên tiến Hàn Quốc (KAIST) cho biết nhóm nghiên cứu của trường đã phát triển CluSTER, một kỹ thuật tinh chỉnh mô hình ngôn ngữ lớn có thể rút ngắn tối đa 69,6% thời gian xử lý mà vẫn duy trì gần như nguyên hiệu năng của mô hình.
Theo KAIST ngày 2/11, nhóm của giáo sư Lee Jae-gil tại Khoa Khoa học Máy tính đã xây dựng CluSTER nhằm chọn lọc dữ liệu có mức đóng góp tương đồng và phân bổ dữ liệu hợp lý trên nhiều bộ xử lý đồ họa (GPU).
Tinh chỉnh là quá trình bổ sung dữ liệu chuyên biệt, chẳng hạn trong lĩnh vực lập trình hoặc y tế, vào một mô hình AI đã có sẵn để cải thiện hiệu năng. Thông thường, dữ liệu được chia cho nhiều GPU để xử lý song song. Tuy nhiên, nếu các GPU liên tục học từ những dữ liệu có giá trị tương tự nhau, hiệu quả tính toán có thể giảm so với lượng tài nguyên bỏ ra.
Để khắc phục vấn đề này, nhóm nghiên cứu phân tích mức đóng góp của từng dữ liệu đối với quá trình học của mô hình, sau đó phân cụm các dữ liệu có tác động tương đồng và chỉ chọn những dữ liệu cần thiết trong mỗi cụm. Phần dữ liệu được chọn sẽ được phân bổ đồng đều lên nhiều GPU, qua đó giảm tình trạng học trùng lặp nhưng vẫn bảo đảm độ đa dạng của thông tin huấn luyện.
Nhóm đã sử dụng ba bộ dữ liệu trong lĩnh vực lập trình và y tế để tinh chỉnh các mô hình ngôn ngữ lớn có 7 tỷ và 13 tỷ tham số, đồng thời kiểm chứng hiệu quả của công nghệ qua 8 bài kiểm thử hiệu năng. Kết quả cho thấy, chỉ với khoảng 31% tổng dữ liệu, mô hình vẫn giữ được gần như nguyên hiệu năng, trong khi thời gian tinh chỉnh giảm tối đa 69,6%, tương đương từ 10 giờ xuống còn khoảng 3 giờ.
Các thử nghiệm chủ yếu được thực hiện trên cấu hình 4 GPU. Nhóm cũng xác nhận CluSTER cho kết quả tốt hơn phương pháp hiện có trong môi trường 8 GPU.
Giáo sư Lee Jae-gil cho biết để nâng hiệu quả học của AI, không chỉ cần tăng số lượng GPU mà còn phải lựa chọn dữ liệu huấn luyện một cách thông minh. Theo ông, ý nghĩa của nghiên cứu nằm ở khả năng tận dụng hiệu quả hơn nguồn lực GPU hiện có, từ đó giảm gánh nặng khi huấn luyện các mô hình AI quy mô lớn.
Nghiên cứu sinh tiến sĩ Kim Hyun-jin, thuộc Khoa Khoa học Máy tính của KAIST, tham gia nghiên cứu với vai trò tác giả thứ nhất. Kết quả nghiên cứu đã được công bố tại EMNLP 2026, hội nghị quốc tế về xử lý ngôn ngữ tự nhiên tổ chức vào tháng 10.
 Jin-ho Lee
jhlee26@d-today.co.kr