
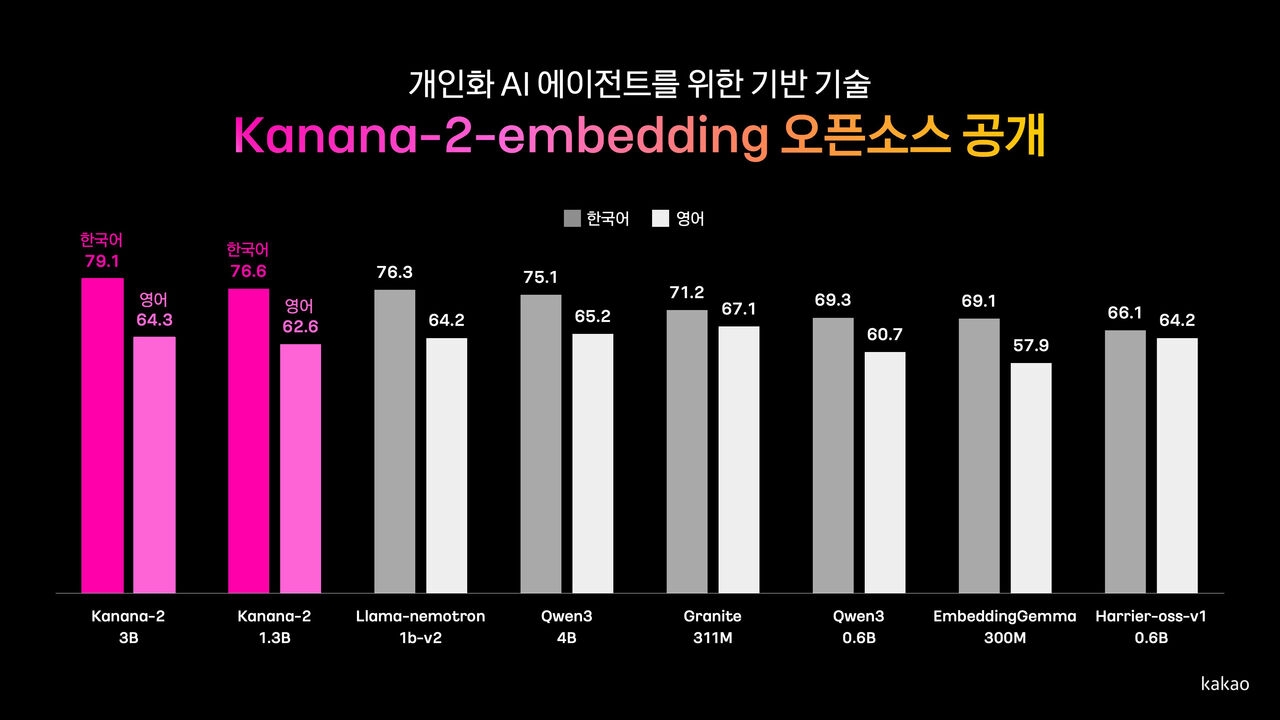
Ngày 29/10, Kakao công bố mã nguồn mở hai mô hình embedding mới trên nền tảng Hugging Face, nhằm phục vụ AI cá nhân hóa và các tác vụ tìm kiếm theo ngữ nghĩa.
Hai mô hình được giới thiệu gồm “Kanana-2-3b-Embedding” với 3 tỷ tham số và “Kanana-2-1.3b-Embedding” với 1,3 tỷ tham số.
Embedding là công nghệ chuyển đổi ý nghĩa của văn bản thành dạng số, từ đó giúp tìm ra thông tin liên quan đến truy vấn. Nhờ khả năng tìm kiếm theo độ tương đồng ngữ nghĩa, mô hình vẫn có thể truy xuất nội dung phù hợp ngay cả khi câu chữ không trùng khớp hoàn toàn. Theo Kakao, công nghệ này có thể được ứng dụng cho AI agent cá nhân hóa khi tra cứu dữ liệu quá khứ, đồng thời phù hợp với các hệ thống tìm kiếm ngữ nghĩa.
Kakao cho biết mô hình 3B được phát triển bằng cách tận dụng năng lực hiểu ngôn ngữ của mô hình ngôn ngữ nhỏ nội bộ “Kanana-2-SLM” cho bài toán truy xuất thông tin. Trên cơ sở đó, công ty tiếp tục áp dụng kỹ thuật chưng cất tri thức để chuyển tri thức từ mô hình lớn sang mô hình nhỏ, qua đó xây dựng phiên bản 1.3B.
Cả hai mô hình đều áp dụng kỹ thuật “MRL” (Matryoshka Representation Learning), cho phép điều chỉnh kích thước vector embedding. Kakao cho hay nhà phát triển có thể lựa chọn kích thước vector phù hợp với từng môi trường dịch vụ để cân bằng giữa hiệu năng tìm kiếm, dung lượng lưu trữ và tốc độ xử lý.
Theo kết quả đánh giá nội bộ của Kakao, khi so sánh với các mô hình cùng quy mô như “Llama-Nemotron-Embed-1b-v2” và “Qwen3-Embedding-4B”, hai mô hình mới đạt hiệu năng tiếng Anh tương đương, trong khi hiệu năng tiếng Hàn ở mức cao nhất. Công ty cũng cho biết hiệu suất suy luận tốt hơn so với Qwen3-Embedding.
So với các phiên bản trước trong dòng Kanana Embedding, hai mô hình mới được cho là cải thiện hiệu năng tìm kiếm, đồng thời tối ưu bộ nhớ và tốc độ suy luận.
Kakao áp dụng “Kanana Open License” cho các mô hình lần này. Theo điều khoản giấy phép, mô hình có thể được sử dụng cho cả hoạt động nghiên cứu và phát triển lẫn mục đích thương mại.
Trong thời gian tới, Kakao cho biết sẽ tiếp tục nghiên cứu huấn luyện mô hình embedding bằng các mô hình ngôn ngữ lớn hơn kết hợp với kỹ thuật chưng cất tri thức, nhằm nâng cao hiệu năng tìm kiếm và hiệu quả vận hành.
Ông Noh Byung-seok, Performance Leader của bộ phận Unified Foundation Model tại Kakao, cho biết công ty sẽ tiếp tục hỗ trợ các nhà nghiên cứu và lập trình viên đưa công nghệ embedding có thế mạnh về tiếng Hàn vào nhiều dịch vụ khác nhau, đồng thời đẩy mạnh nghiên cứu để nâng cao hiệu năng và hiệu quả vận hành.
 Hojeong Lee
lhj@d-today.co.kr