
TypeSafe AI, startup do các cựu nhân sự OpenAI sáng lập, vừa giới thiệu Jev - một mô hình AI mới được thiết kế chuyên cho tác vụ ra quyết định thay vì tạo văn bản. Ngay sau khi ra mắt, Jev nhanh chóng thu hút sự chú ý trong giới công nghệ, đặc biệt ở mảng đánh giá AI agent.
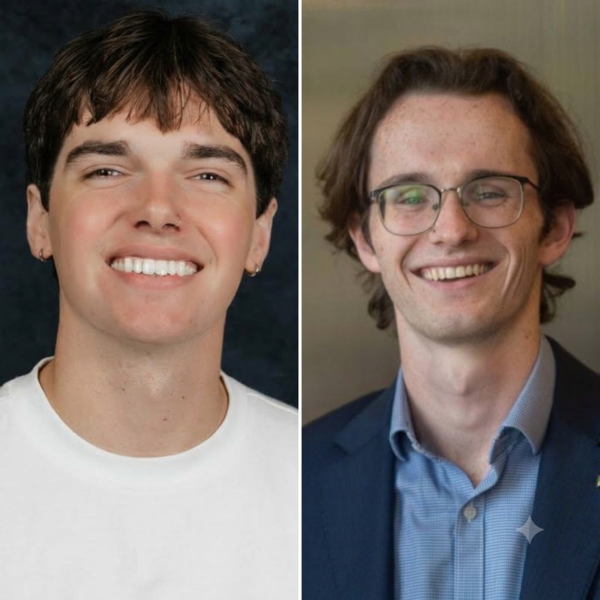
Daniel Shea và Sean Roche, hai thành viên của LangChain - công ty phát triển framework ứng dụng AI - đã đăng bài phân tích về Jev, tập trung vào khả năng ứng dụng mô hình này trong bài toán đánh giá AI agent.
Theo TypeSafe AI, Jev thuộc nhóm mô hình “System 1” và có cách tiếp cận khác biệt đáng kể so với các mô hình ngôn ngữ lớn hiện nay. Thay vì viết câu trả lời hoặc duy trì hội thoại như ChatGPT, Jev được thiết kế để đưa ra các phán đoán ngắn gọn, có cấu trúc, phục vụ trực tiếp cho quy trình phần mềm.
Ví dụ, khi nhận một yêu cầu từ khách hàng, Jev có thể xác định đây là trường hợp liên quan đến hoàn tiền. Kết quả này sau đó được hệ thống chăm sóc khách hàng sử dụng để tự động chuyển ticket tới đúng nhóm phụ trách.
Đầu ra của Jev không phải những đoạn phản hồi dài, mà là các quyết định theo định dạng xác định sẵn, chẳng hạn “chuyển sang nhóm hoàn tiền”. Nói cách khác, đây không phải mô hình AI mạnh về viết lách hay đối thoại, mà là công cụ chuyên xử lý các quyết định đơn giản trong quy trình làm việc. Với AI agent, những quyết định dạng này có thể được giao cho Jev thay vì phải liên tục gọi tới LLM đa năng.
Bài viết của LangChain cho biết hiện có hai cách phổ biến để đánh giá agent. Thứ nhất là đánh giá dựa trên mã nguồn, và thứ hai là dùng LLM làm giám khảo theo cách tiếp cận LLM-as-a-judge.
Theo hai tác giả, phương pháp dựa trên mã nguồn có ưu điểm là nhanh và rẻ, nhưng phạm vi đánh giá hẹp. Cách này có thể kiểm tra agent có gọi đúng công cụ hay không, song khó xác định câu trả lời cuối cùng có thực sự chính xác hay không, nhất là với những bài toán có nhiều đáp án chấp nhận được.
Trong khi đó, LLM-as-a-judge có thể lấp khoảng trống này bằng cách đọc đồng thời câu hỏi, nhật ký hành động và tài liệu tham chiếu để đưa ra kết luận. Tuy nhiên, nhược điểm là kết quả có thể thay đổi giữa các lần chạy, tốc độ xử lý chậm hơn và chi phí cao hơn.
Daniel Shea và Sean Roche cho rằng Jev mở ra một hướng tiếp cận khác. Theo họ, về bản chất, đánh giá agent là một bài toán ra quyết định: mô hình cần nhìn vào trạng thái và hành vi của agent để đưa ra phán đoán.
Jev được tối ưu đúng cho kiểu tác vụ này, trong khi LLM thông thường phải tạo đầu ra theo từng token trước khi đi tới kết luận.
Để kiểm chứng, LangChain đã xây dựng một agent thử nghiệm bằng framework nội bộ Deep Agents. Nhóm tác giả tạo bộ dữ liệu gồm 5 câu hỏi về thời tiết, sau đó sử dụng cùng một nhật ký thực thi để Jev, GPT-5.6 Luna, GPT-5.6 Terra và Claude Sonnet 4.6 lần lượt chấm điểm. Mỗi mô hình được chạy lặp lại 100 lần, còn điểm do con người chấm được dùng làm chuẩn đối chiếu.
Theo kết quả được công bố, Jev đạt độ chính xác tuyệt đối khi cả 500 lượt phán đoán đều trùng khớp với chuẩn của con người. GPT-5.6 Terra đạt 99,8%, GPT-5.6 Luna đạt 96,4% và Claude Sonnet 4.6 đạt 80%.
Không chỉ có độ chính xác cao, Jev còn ghi nhận mức dao động kết quả thấp nhất. Độ lệch trung bình của mô hình này là 0,0000149, thấp hơn Luna 433 lần, thấp hơn Terra 913 lần và thấp hơn Claude 92 lần.
Nhóm tác giả cho biết chưa thể đưa ra kết luận dứt khoát về nguyên nhân chỉ từ một thí nghiệm. Tuy vậy, họ cho rằng việc mô hình được huấn luyện để trả về đáp án theo cấu trúc dữ liệu xác định sẵn có thể là một yếu tố ảnh hưởng đến kết quả.
Khác biệt về chi phí và tốc độ cũng là điểm đáng chú ý. Jev mất trung bình 0,44 giây và 0,00035 USD cho mỗi lần xử lý. Trong khi đó, với cùng bài toán, Claude tiêu tốn tổng cộng 28,17 USD, còn tổng chi phí của Jev chỉ vào khoảng 0,34 USD.
Theo hai tác giả, chi phí thấp có thể giúp hoạt động đánh giá được triển khai thường xuyên hơn và trên quy mô lớn hơn. Với các agent vận hành trong môi trường thực tế, nơi có thể phát sinh 10.000 nhật ký mỗi ngày, chênh lệch chi phí như vậy có thể ảnh hưởng trực tiếp đến cách tổ chức vận hành.
Dù đánh giá cao tiềm năng của Jev, nhóm tác giả vẫn giữ quan điểm thận trọng. Họ nhấn mạnh rằng chi phí thấp không đồng nghĩa với chất lượng tốt hơn, bởi một “giám khảo” đưa ra phán đoán sai một cách nhất quán có thể tạo ra khối lượng phản hồi sai rất lớn. Vì vậy, việc con người rà soát và đối chiếu kết quả của mô hình với đánh giá thực tế vẫn là cần thiết.
Nhóm cũng lưu ý rằng thí nghiệm hiện mới chỉ dừng ở một trường hợp cụ thể. Cần thêm dữ liệu để xác nhận liệu kết quả này có thể lặp lại với các agent khác hoặc trong môi trường vận hành thực tế hay không.
Dù vậy, hai tác giả vẫn tỏ ra lạc quan. Theo họ, các mô hình thuộc nhóm System 1 có thể góp phần phổ cập hoạt động đánh giá chất lượng cao, biến nhiều nhật ký thực thi thành tín hiệu phản hồi hữu ích, qua đó giúp phát hiện vấn đề sớm hơn và rút ngắn chu kỳ phát triển.
 Chi-gyu Hwang
delight@d-today.co.kr