韩国科学技术院(KAIST)研究团队研发出一项大语言模型微调新技术,在基本维持模型表现的情况下,可将微调耗时最高缩短69.6%。
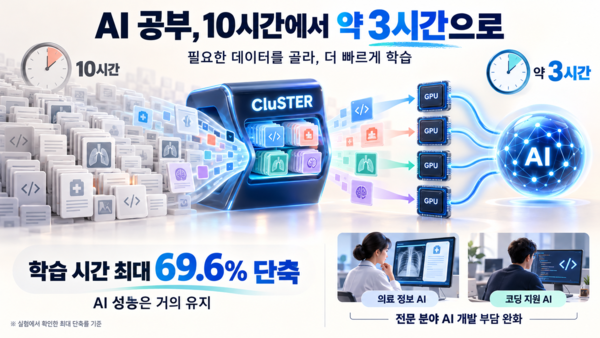
KAIST于11月2日表示,计算机学院Lee Jae-gil教授团队开发出名为“CluSTER”的微调技术。该技术可筛选出对训练贡献相近的数据,并将其均衡分配到多块图形处理器(GPU)上,以提升训练效率。
所谓微调,是指在已有AI模型基础上,利用编程、医疗等特定领域数据继续训练,从而提升模型在相关任务中的表现。通常,这一过程会由多块GPU分担数据处理任务;但如果不同GPU反复处理贡献相近的数据,容易造成计算重复,导致算力投入增加而训练增益有限。
为解决这一问题,研究团队首先分析各类数据对AI训练的影响,再将能够产生相近训练效果的数据进行分组,并从各组中筛选出所需样本。随后,团队把筛选后的数据均衡分配至多块GPU,在减少重复学习的同时,尽可能保留训练信息的多样性。
研究团队使用编程和医疗领域的3类数据,对70亿级和130亿级参数的大语言模型进行微调,并通过8项性能评估验证效果。结果显示,仅使用全量数据约31%,便可在基本维持模型表现的情况下,将训练时间最高缩短69.6%,相当于把原本10小时的训练压缩至约3小时。相关实验主要在4块GPU环境下进行,在8块GPU环境下也验证了其表现优于现有方法。
Lee Jae-gil表示,提高AI训练效率并不只是增加GPU数量,更重要的是如何智能选择训练数据。这项研究的意义在于,无需额外增加GPU资源,也能更高效地利用现有算力,从而减轻大规模AI模型训练负担。
此次研究由KAIST计算机学院博士生Kim Hyun-jin担任第一作者。相关成果已于10月在自然语言处理领域国际学术会议“EMNLP 2026”上发表。
记者信息
 Jin-ho Lee
jhlee26@d-today.co.kr