能够模拟与真人偶像对话的AI聊天机器人服务,近期在业内持续受到关注。其背后的核心技术在于,如何将用于提升大语言模型(LLM)回复质量的Persona机制,与真人资料和长记忆能力结合,并真正落地为产品服务。
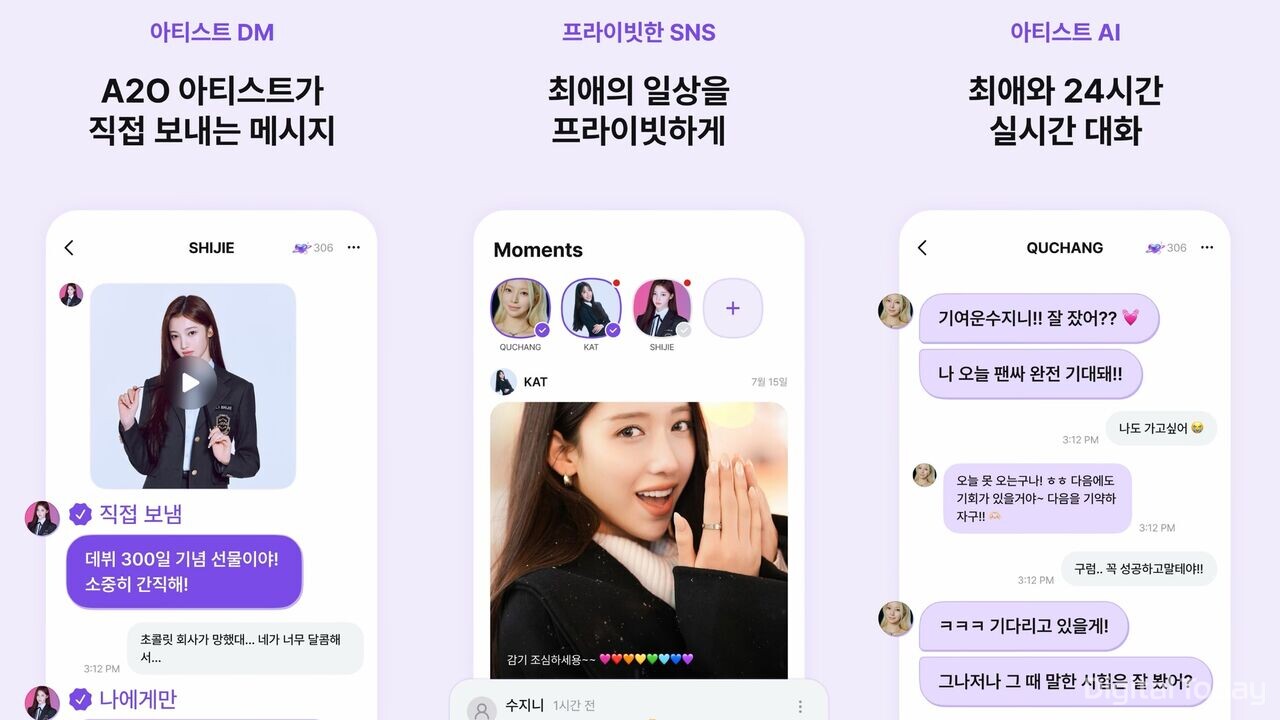
据AI业内消息,AI初创公司Mindlogic开发的粉丝沟通平台“BloomingTalk”,正凭借真人偶像AI聊天服务吸引市场关注。用户可与SM Entertainment创始人Lee Soo-man推出的偶像组合A2O(Soul·Light)24名成员的AI化身进行文字聊天,并发起语音和视频通话。Mindlogic负责应用开发,ESTsoft负责AI视频虚拟形象制作。公司表示,该团体入驻后,上线前5天对话量约100万次,付费金额达到数千万韩元水平。
要实现贴近真人的人设,第一步是对人物特征进行收集和分析,包括性格、说话方式、偏好和兴趣点等,并整理为AI可调用的结构化信息。为此,通常需要使用访谈、个人资料、历史消息、视频、音频等多类素材。随着人物数量增加,相关信息收集和分析所需的时间与成本也会同步上升。
为提高效率,Mindlogic让AI直接与艺人对话,自动收集并分析其性格、说话方式和近期关注点等信息。公司将这一机制称为“AI采访员”,并将获取的信息与既有资料结合使用,以减少人工整理负担。
另一个关键点在于,如何把收集到的信息尽可能准确地体现在AI回复中。对于这类服务而言,仅仅模仿语气并不够,系统还需要生成符合艺人偏好和背景知识的回答。系统把艺人资料设为回复生成的核心依据;至于演出日程等变化频繁的信息,则由经纪团队单独录入,以提高准确性。
在此基础上,系统还引入了用于维持对话上下文的长记忆能力。Persona负责保持艺人固有的性格和对话风格,长记忆则基于每位粉丝持续积累的信息,支持更具连续性的个性化互动。
例如,当粉丝提到自己正在准备求职时,AI在下一次对话中可以继续追问面试结果。相反,如果AI忘记此前的聊天内容,或提及错误信息,用户“像在与真人交流”的沉浸感就会明显下降。
这类能力的难点在于,既要筛选真正值得保留的记忆内容,又要控制计算成本。如果每次都把完整历史对话输入模型,信息量和推理成本都会迅速上升。对此,Mindlogic选择从对话中抽取关键信息并进行结构化处理。
这一做法不同于依赖外部资料检索增强回复的RAG路径。Mindlogic会把从对话中提取出的用户姓名、偏好、职业等信息整理为个人档案,并写入系统提示词,从而在不反复处理全部聊天记录的情况下,维持针对单个用户的上下文连续性。
在信息筛选过程中,系统还会为不同信息设置可信度优先级。平台会区分“用户主动输入的信息”与“AI在对话中推断出的内容”;一旦两者出现冲突,系统以前者为准,以避免AI的错误推断被长期当作事实保留下来。
Mindlogic相关人士表示,AI会像人的记忆一样区分“重要”和“不重要”的内容,并将用户姓名、兴趣、职业、偏好等有助于理解对方的信息分类存储。随着对话不断积累,系统也会越来越多地反映每位用户各自的个体语境。
 Seul-gi Son
sageson@d-today.co.kr