
Kakao开源发布两款Embedding模型,瞄准个性化AI智能体和语义搜索等应用场景。
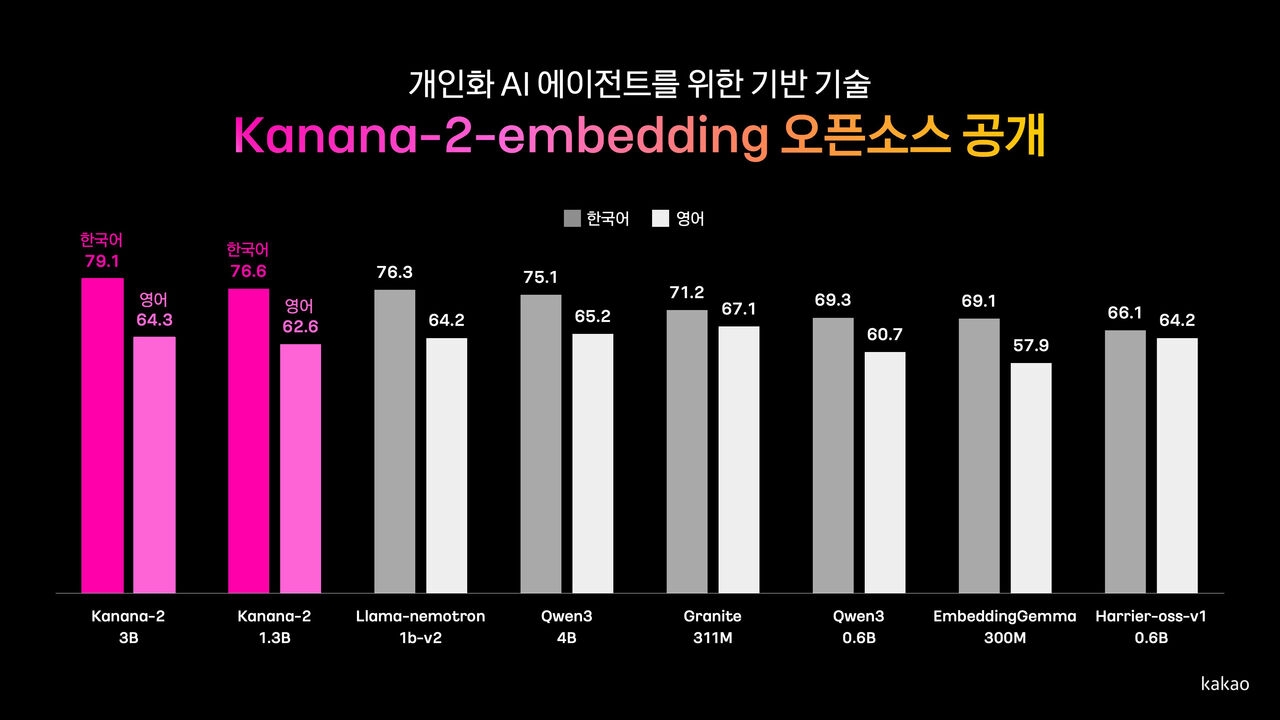
Kakao于10月29日表示,已在Hugging Face上线30亿参数的“Kanana-2-3B-Embedding”和13亿参数的“Kanana-2-1.3B-Embedding”。
Embedding模型可将文本语义转换为数值向量,用于语义检索。即使关键词并不完全匹配,系统也能基于语义相似度查找相关信息,因此可应用于个性化AI智能体的历史信息检索、语义搜索等任务。
据Kakao介绍,30亿参数版本基于公司自研小型语言模型(SLM)“Kanana-2-SLM”开发,将其语言理解能力用于检索训练;13亿参数版本则在此基础上通过知识蒸馏构建,将大模型学到的能力迁移至更小模型。
两款模型均引入MRL(Matryoshka Representation Learning)技术,支持按需调整Embedding向量维度。开发者可根据实际服务环境,在检索效果、存储成本和处理速度之间进行权衡。
Kakao表示,在与同级别模型“Llama-Nemotron-Embed-1B-v2”和“Qwen3-Embedding-4B”的对比中,这两款开源发布的模型在韩语任务上的表现更优,在英语任务上的表现则处于相近水平。与Qwen3-Embedding-4B相比,其推理效率也更高。
与现有Kanana Embedding系列相比,新模型进一步提升了检索性能,同时降低了内存占用并提升了推理速度。
此次发布的模型采用“Kanana开放许可”。根据许可条款,除研究和开发用途外,也支持商业使用。
Kakao表示,后续将继续推进基于更大语言模型的Embedding训练和知识蒸馏研究,进一步提升检索性能和运行效率。
Kakao Unified Foundation Model负责人Roh Byung-seok表示,公司将支持研究人员和开发者把更擅长韩语的Embedding技术应用于各类服务,并持续推进兼顾检索性能与效率的相关研究。
 Hojeong Lee
lhj@d-today.co.kr