
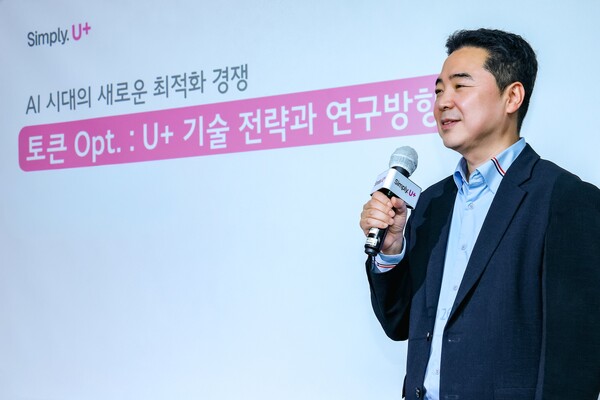
LGU+ ngày 15/11 cho biết đang đẩy mạnh phát triển các công nghệ tối ưu token nhằm giảm chi phí vận hành dịch vụ AI, đồng thời duy trì chất lượng đầu ra. Doanh nghiệp tập trung vào việc chọn mô hình phù hợp theo từng tác vụ và phân bổ linh hoạt GPU, NPU để tối ưu hiệu quả hạ tầng.
Tại buổi gặp gỡ báo chí gần đây, LGU+ đã công bố kết quả nghiên cứu cùng kế hoạch thương mại hóa liên quan đến tối ưu token AI. Công ty giới thiệu các kỹ thuật và kinh nghiệm tích lũy trong quá trình vận hành dịch vụ, trong đó có một bài báo được chọn vào workshop thuộc hội nghị AI quốc tế NeurIPS.
Theo LGU+, token là đơn vị cơ bản được sử dụng khi người dùng đặt câu hỏi cho AI hoặc khi AI tạo câu trả lời. Khi mức sử dụng dịch vụ AI tăng lên, nhu cầu tài nguyên tính toán và chi phí xử lý token cũng tăng theo. Đặc biệt, xu hướng gia tăng khối lượng suy luận, tức quá trình AI tạo phản hồi dựa trên dữ liệu đã học, đang khiến bài toán tối ưu token trở nên quan trọng hơn.
Bà Lee Hye-jin, phụ trách chiến lược công nghệ của LGU+, cho biết token được tiêu thụ trong hầu hết mọi tương tác với AI. Theo bà, để nâng hiệu quả tiết giảm chi phí, doanh nghiệp cần kết hợp nhiều kỹ thuật thay vì phụ thuộc vào một công nghệ đơn lẻ.
LGU+ dự kiến tận dụng kinh nghiệm vận hành mô hình tích lũy từ dịch vụ AI ixi-O, AI contact center và các dự án chuyển đổi AI nội bộ để phát triển công nghệ tối ưu token. Với ixi-O, công ty cho biết đã tối ưu đồng thời chất lượng và chi phí thông qua việc kết hợp nhiều mô hình, gồm mô hình tự phát triển, EXAONE của LG AI Research và Google Gemini.
Doanh nghiệp cũng kỳ vọng tích lũy thêm kinh nghiệm từ dịch vụ “AI cho mọi người”, dự kiến thương mại hóa vào cuối năm nay cùng Kakao. Từ năm sau, LGU+ sẽ mở rộng hoạt động tối ưu token sang mảng B2B.
Định tuyến mô hình, nén mô hình để giảm chi phí suy luận
LGU+ cho biết đang phát triển công nghệ tối ưu token trên toàn bộ chuỗi dịch vụ AI, từ AI agent, AI gateway, mô hình, suy luận cho đến hạ tầng tính toán.
Một trong những công nghệ chủ lực là “định tuyến mô hình” (model routing), tức phân bổ tác vụ sang mô hình phù hợp sau khi phân tích loại câu hỏi và độ phức tạp. Những tác vụ như tóm tắt hoặc dịch thuật có thể được xử lý bằng mô hình gọn nhẹ, trong khi các câu hỏi đòi hỏi đánh giá chuyên sâu sẽ được chuyển sang mô hình hiệu năng cao hơn.
Theo kết quả thử nghiệm khái niệm do LGU+ công bố, định tuyến mô hình giúp duy trì khoảng 95% chất lượng câu trả lời, đồng thời cắt giảm khoảng 25% chi phí token. Với AI agent viết code dùng trong nội bộ, công ty cũng ghi nhận chi phí giảm khoảng 30% nhờ áp dụng kỹ thuật này.
Ngoài ra, trong một số tác vụ lập trình sử dụng mô hình AI tự phát triển, LGU+ cho biết chi phí vận hành đã giảm khoảng 90% so với mô hình thường dùng. Kết quả này được công ty xác nhận là tách biệt với hiệu quả từ định tuyến mô hình.
Bên cạnh đó, LGU+ đang nghiên cứu lượng tử hóa và chưng cất tri thức để thu gọn mô hình AI. Trong đó, lượng tử hóa giúp giảm số bit cần thiết để biểu diễn các giá trị trong mô hình, còn chưng cất tri thức là quá trình chuyển tri thức từ mô hình lớn sang mô hình nhỏ hơn.
Theo thử nghiệm nội bộ, khi thu gọn mô hình từ 35 tỷ tham số xuống 10 tỷ tham số, chất lượng vẫn được duy trì ở mức 91%, trong khi tốc độ tạo token tăng 40%. Với mô hình AI chạy trên thiết bị, công ty cũng giảm dung lượng từ 2,4-3 GB xuống khoảng 800 MB và đạt hơn 95% hiệu năng so với mô hình đám mây dùng làm chuẩn đối chiếu.
LGU+ đồng thời giới thiệu kỹ thuật “speculative decoding”, trong đó mô hình nhỏ tạo trước các phương án trả lời để mô hình lớn xác thực. Trong thử nghiệm dựa trên EXAONE, số token được tạo ra mỗi giây tăng gấp đôi, từ 80 lên 160.
Phối hợp GPU-NPU, hướng tới mở rộng B2B từ năm sau
Ở lớp hạ tầng, LGU+ đang cải thiện hiệu quả sử dụng chip cho dịch vụ AI thông qua chiến lược “chip-mix”, kết hợp linh hoạt GPU của Nvidia và AMD cùng NPU của FuriosaAI theo đặc tính từng tác vụ.
Theo công ty, suy luận AI gồm hai giai đoạn chính là “prefill” -phân tích câu hỏi và “decoding” -tạo câu trả lời. Dựa trên đặc điểm của từng bước, LGU+ phân bổ loại chip phù hợp: prefill đòi hỏi năng lực tính toán lớn, trong khi decoding phụ thuộc nhiều hơn vào khả năng xử lý bộ nhớ.
LGU+ cho biết đã hợp tác với FuriosaAI hơn hai năm để kiểm chứng khả năng ứng dụng NPU. Mục tiêu là giảm phụ thuộc vào một loại chip duy nhất và phối hợp thiết bị theo từng tác vụ để hạ chi phí vận hành hạ tầng AI.
Một hướng nghiên cứu trọng tâm khác là “harness engineering”, kỹ thuật nhằm cắt giảm các tác vụ lặp lại không cần thiết của AI agent. Cách tiếp cận này giới hạn công cụ và phạm vi thực thi của agent, đồng thời tái sử dụng những quy trình đã chứng minh hiệu quả.
Theo LGU+, ở các trường hợp thử nghiệm, lượng token sử dụng giảm 38% với tác vụ thông thường và giảm 84% với tác vụ lập trình.
Công ty dự kiến áp dụng các công nghệ này cho các dự án chuyển đổi AI nội bộ và những dịch vụ AI hiện có, đồng thời thúc đẩy thương mại hóa trong mảng B2B từ năm sau thông qua hợp tác với đối tác và xây dựng hạ tầng riêng. Mục tiêu, theo LGU+, không chỉ là hạ đơn giá theo token mà còn giảm tổng chi phí để khách hàng doanh nghiệp hoàn thành một tác vụ bằng AI.
Ông Lee Sang-yeop, CTO của LGU+, nhấn mạnh bài toán tối ưu hóa không thể được giải quyết chỉ bằng một công nghệ đơn lẻ. Theo ông, doanh nghiệp cần kết hợp công nghệ và thiết bị khác nhau tùy mục tiêu sử dụng. LGU+ cũng hướng tới việc giảm “đơn giá cho toàn bộ tác vụ”, thay vì chỉ giảm đơn giá token, với trọng tâm là nâng hiệu quả xử lý công việc thực tế cho khách hàng.
 Jin-ho Lee
jhlee26@d-today.co.kr