
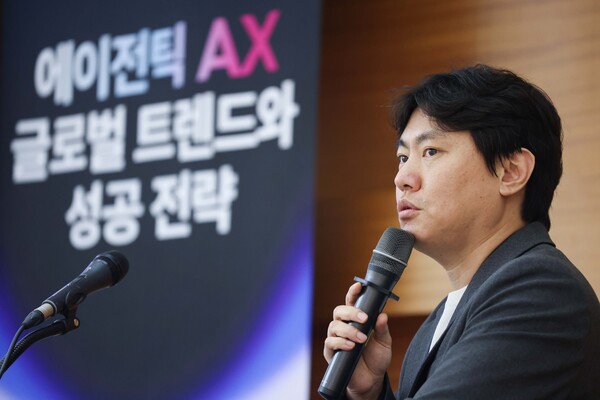
Tại hội nghị Digital Insight 2026 do DigitalToday tổ chức ở COEX, Seoul ngày 29/9, Encoa cho rằng yếu tố quyết định hiệu quả triển khai AI agent không nằm ở mô hình hay nền tảng, mà ở mức độ sẵn sàng của dữ liệu doanh nghiệp.
“Dù cùng dùng một mô hình AI, kết quả vẫn có thể rất khác nhau. Điểm tạo ra khác biệt không phải là mô hình, mà là mức độ sẵn sàng của dữ liệu”, ông Kim Ki-dong, trưởng nhóm tại Encoa, nói tại sự kiện.
Theo ông Kim Ki-dong, để AI agent có thể khai thác dữ liệu doanh nghiệp một cách hiệu quả, trước hết doanh nghiệp phải “dạy” cho agent hiểu dữ liệu đó có ý nghĩa gì và liên kết với các dữ liệu khác ra sao.
Ông cho biết nhiều doanh nghiệp đã áp dụng các mô hình và nền tảng AI hàng đầu, đồng thời đạt kết quả tốt trong giai đoạn PoC và demo. Tuy nhiên, khi đưa vào triển khai thực tế, AI agent thường không đạt được hiệu quả như kỳ vọng.
Nguyên nhân chủ yếu nằm ở khâu kết nối dữ liệu hiện hữu với AI trong môi trường vận hành. Theo Encoa, phần lớn cấu trúc dữ liệu sẵn có không được thiết kế cho nhu cầu của AI agent. Vì vậy, agent có thể hoạt động tốt trong môi trường demo, nhưng gặp hạn chế khi triển khai thực tế.
Một vấn đề phổ biến là doanh nghiệp thường đặt tên bảng dữ liệu khó nhận diện vì lý do bảo mật hoặc vận hành. Nhiều cột dữ liệu không có mô tả, hoặc có mô tả nhưng khó hiểu. Không ít trường hợp còn sử dụng các chữ viết tắt chỉ nhân sự nội bộ mới nắm được.
Ngoài ra, nhiều hệ thống cũng không gắn thông tin quan hệ giữa các bảng dữ liệu vì lo ngại ảnh hưởng hiệu năng. Với các hệ thống khác nhau, tình trạng thiếu hoàn toàn thông tin liên kết cũng diễn ra khá phổ biến.
Ông Kim Ki-dong lấy ví dụ về mối liên hệ giữa dữ liệu đầu vào của hệ thống vận hành sản xuất và dữ liệu xuất hàng trong hệ thống ERP. Trong nhiều doanh nghiệp, cách hai tập dữ liệu này kết nối với nhau chỉ người phụ trách nắm rõ hoặc chỉ được ghi lại trong tài liệu thiết kế.
Theo Encoa, doanh nghiệp không phải không biết có thể bổ sung mô tả và định nghĩa quan hệ cho dữ liệu, nhưng việc này trở nên khó khăn do cấu trúc dữ liệu legacy. “AI không thể tự tạo ra thông tin chưa tồn tại. Vì vậy, doanh nghiệp phải chuẩn bị sẵn những thông tin cần thiết cho dữ liệu mà AI sẽ sử dụng”, ông nói.
Từ đó, Encoa đưa ra cách hiểu về khái niệm dữ liệu AI-ready. Theo ông Kim Ki-dong, nhiều người cho rằng AI-ready đơn giản là dữ liệu sạch và có chất lượng cao. Tuy nhiên, đó chỉ là một phần điều kiện. Dữ liệu AI-ready phải là dữ liệu mà AI có thể hiểu được và có thể tin cậy để sử dụng.
Ông cho rằng dữ liệu AI-ready cần đáp ứng ba nhóm điều kiện.
Thứ nhất là khả năng nhận diện. Muốn tìm được dữ liệu, agent phải biết dữ liệu đó là gì. Thứ hai là khả năng truy vết quan hệ, tức phải hiểu dữ liệu kết nối với nhau như thế nào. Thứ ba là kiểm soát ngữ cảnh, nghĩa là agent chỉ được truy cập trong phạm vi dữ liệu được phép. Theo Encoa, doanh nghiệp cần xác định rõ ai được xem dữ liệu nào và đến mức nào để vận hành agent an toàn.
Ông Kim Ki-dong cũng nhấn mạnh dữ liệu AI-ready không giống metadata truyền thống. Metadata phục vụ quản trị cơ sở dữ liệu thường tập trung vào thông tin cấu trúc, chẳng hạn bảng hay cột có tồn tại hay không, có tuân thủ tiêu chuẩn hay không, hoặc thay đổi ở đâu sẽ ảnh hưởng đến đâu.
Trong khi đó, nhu cầu của AI agent lại khác. Nếu metadata truyền thống trả lời câu hỏi “có gì”, thì agent cần biết “nghĩa là gì” và “được dùng như thế nào”. Theo Encoa, trước khi AI agent xuất hiện, những thông tin này thường do người phụ trách tự nắm bằng kinh nghiệm hoặc ghi lại trong tài liệu. Vì vậy, dữ liệu AI-ready không thay thế metadata, mà bổ sung thêm lớp thông tin về ý nghĩa và mối liên kết dữ liệu trên nền metadata hiện có.
Encoa gọi cách tiếp cận này là “bản đồ ngữ cảnh”. Theo công ty, bản đồ ngữ cảnh quản lý 5 yếu tố gồm mô tả dữ liệu, tên gọi trong nghiệp vụ, mục đích sử dụng, thông tin quan hệ và quyền truy cập.
Trên nền tảng này, agent dùng tìm kiếm vector để xác định dữ liệu có thuật ngữ và ý nghĩa tương đồng, đồng thời dùng tìm kiếm đồ thị để lần theo mối liên kết giữa các dữ liệu. Thay vì suy đoán dựa trên tên bảng, agent có thể trả lời dựa trên ý nghĩa và quan hệ đã được định nghĩa sẵn.
Ông Kim Ki-dong nêu ví dụ về trường hợp dữ liệu “mặt hàng khách hàng ưa thích” trở thành dữ liệu nhạy cảm. Nếu mỗi agent đều gắn quy tắc riêng, doanh nghiệp sẽ phải sửa toàn bộ 10 agent. Nhưng với bản đồ ngữ cảnh, chỉ cần chỉnh sửa định nghĩa tại một nơi mà không phải can thiệp vào từng agent.
Dù vậy, Encoa cho rằng việc tìm được dữ liệu cần thiết không đồng nghĩa hệ thống có thể ngay lập tức tạo ra câu trả lời. Chẳng hạn, khi cần xác định một vấn đề về vật tư ảnh hưởng tới những mặt hàng nào, bản đồ ngữ cảnh có thể tìm ra 4 bảng liên quan, nhưng không thể tự xác định phải ghép 4 bảng đó theo thứ tự nào và với điều kiện gì.
Để giải quyết bài toán này, ông Kim Ki-dong đề xuất sử dụng semantic model. Theo ông, semantic model là tiêu chuẩn giúp thống nhất ý nghĩa của các thuật ngữ nghiệp vụ như “khách hàng”, “đơn hàng”, đồng thời gắn kết dữ liệu tương ứng với từng thuật ngữ.
Từ semantic model, một nhánh sẽ bổ sung ý nghĩa lên metadata để tạo thành đồ thị metadata, tức bản đồ ngữ cảnh. Nhánh còn lại xây dựng đồ thị instance để kết nối dữ liệu thực theo luồng nghiệp vụ.
Ông Kim Ki-dong cho biết hệ thống sẽ dùng đồ thị metadata khi tìm dữ liệu, còn khi tạo câu trả lời sẽ sử dụng đồ thị instance. Cả hai đều được xây dựng từ cùng một semantic model.
“Khi mô hình và công nghệ AI tiếp tục cải thiện, năng lực thực sự của agent vẫn phụ thuộc vào mức độ chuẩn bị dữ liệu của doanh nghiệp”, ông nói.
 Chi-gyu Hwang
delight@d-today.co.kr