
Qualcomm cho biết smartphone dùng Snapdragon 8 Elite thế hệ thứ 6 có thể vận hành mô hình AI tới 30 tỷ tham số ngay trên thiết bị. Theo hãng, bước tiến này đến từ việc mở rộng bộ nhớ của NPU, tối ưu cách phân bổ dữ liệu giữa NPU, DRAM và bộ nhớ flash, đồng thời áp dụng cùng cách tiếp cận đó lên CPU.
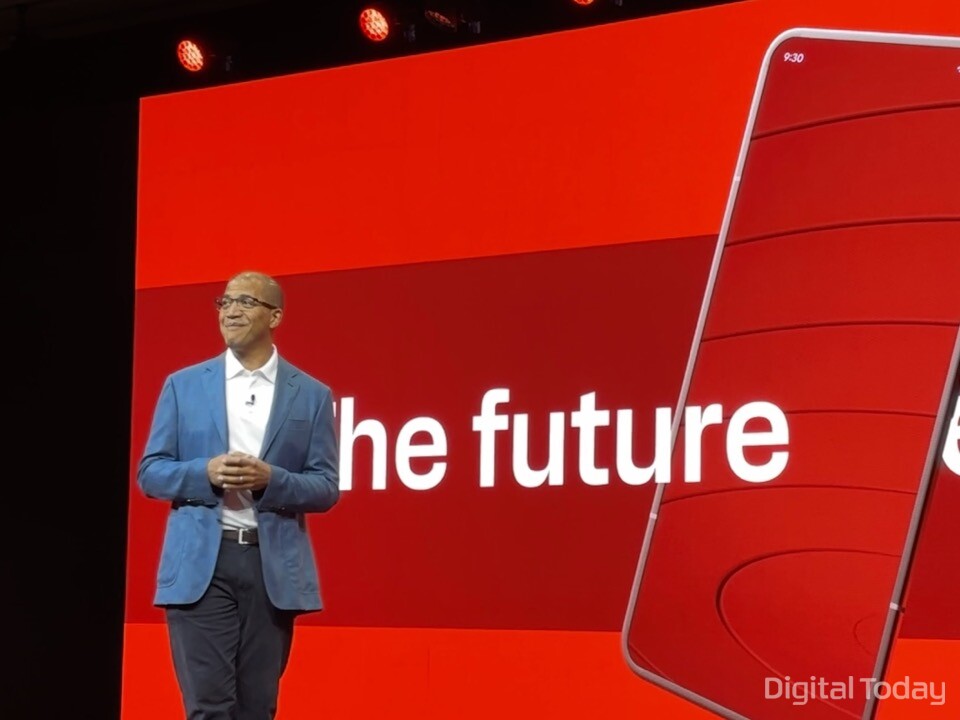
Phát biểu tại Snapdragon Summit 2026 tổ chức ở Maui, Mỹ, ngày 22/9 (giờ địa phương), ông Chris Patrick, Phó chủ tịch cấp cao kiêm lãnh đạo mảng thiết bị cầm tay của Qualcomm, nói rằng khi AI agent đảm nhiệm nhiều việc hơn cho người dùng, hệ thống sẽ cần những mô hình lớn hơn, khả năng suy luận mạnh hơn và lượng ngữ cảnh phong phú hơn.
Theo ông, để agent có thể xử lý công việc thay người dùng, hệ thống phải suy luận qua nhiều bước, tìm đúng ngữ cảnh và gọi các công cụ cần thiết. Vì vậy, quy mô mô hình và độ dài ngữ cảnh có thể xử lý trong một lần chạy đều phải tăng lên.
Tại sự kiện, Qualcomm ra mắt nền tảng di động cao cấp Snapdragon 8 Elite thế hệ thứ 6 và cho biết con chip này có thể chạy mô hình AI 30 tỷ tham số trực tiếp trên smartphone. Cách làm là chỉ nạp vào bộ xử lý những phần dữ liệu cần thiết từ bộ nhớ flash, trong khi dữ liệu được truy cập thường xuyên sẽ được giữ lại trong NPU. Qualcomm cho biết bộ nhớ chia sẻ của Hexagon NPU đã được mở rộng thêm 50%.
Trước đó, tại buổi họp báo trước sự kiện, Qualcomm cho biết hãng đã xác định rõ nút thắt về bộ nhớ của ngành và đang thay đổi kiến trúc để đưa dữ liệu đến gần nơi xử lý hơn. Theo thiết kế được giới thiệu tại hội nghị, Hexagon NPU có thể lưu nhiều ngữ cảnh và KV cache hơn trong vùng bộ nhớ chia sẻ đã được mở rộng. KV cache là vùng nhớ tạm dùng để lưu phần nội dung mà mô hình đã đọc trước đó, giúp tránh phải tính toán lại.
Qualcomm cho biết khi dữ liệu được giữ trong NPU, số lần truy xuất qua lại tới bộ nhớ DRAM bên ngoài sẽ giảm xuống, từ đó rút ngắn độ trễ. Hãng cũng bổ sung bộ tăng tốc Element Accelerator, hỗ trợ cửa sổ ngữ cảnh lên tới 32.000 token. Với một số mô hình, hiệu năng ở giai đoạn prefill - bước mô hình đọc dữ liệu đầu vào ban đầu - có thể tăng tối đa 80%.
Ngoài NPU, Qualcomm còn kết hợp kiến trúc Mixture of Experts (MoE) với bộ nhớ flash. Với MoE, mô hình chỉ kích hoạt các “chuyên gia” liên quan ở từng bước xử lý, nhờ đó giảm khối lượng tính toán và nhu cầu băng thông bộ nhớ so với mô hình dense, vốn phải huy động phần lớn mạng trong mỗi bước suy luận. Qualcomm cho biết trong mỗi lần tạo token, mô hình chỉ kích hoạt khoảng 3 tỷ tham số và có thể chạy trực tiếp từ bộ nhớ flash bằng cách kết hợp UFS 5.0 với hệ thống quản lý flash thông minh do hãng tự phát triển.
Trong phần trình diễn tại keynote, Qualcomm giới thiệu một AI agent chạy trên mô hình này. Agent đọc thư mời tham dự hội nghị, xác định ngày, chuyến bay và địa điểm, sau đó tự lập lịch trình trong ba ngày. Ngày đầu tiên dành cho việc di chuyển, nhận phòng và tham dự bữa tối chào mừng. Sang ngày thứ hai, hệ thống sắp xếp các cuộc họp vào những khung giờ trống. Ngày thứ ba được ưu tiên cho keynote và khu vực tiếp khách tại gian hàng. Theo Qualcomm, MoE sẽ kích hoạt các “chuyên gia” khác nhau ở từng giai đoạn như hiểu ngữ cảnh, suy luận và thực thi tác vụ.
Qualcomm cho biết với kiến trúc thế hệ trước, hãng không thể vận hành mô hình MoE vượt mốc 30 tỷ tham số trên smartphone. Trên nền tảng mới, công ty đồng thời cải tiến cấu trúc NPU, bổ sung Element Accelerator và mở rộng bộ nhớ trong NPU. Theo Qualcomm, hướng tiếp cận này cho phép tăng quy mô mô hình bằng cách phân bổ dữ liệu hợp lý giữa bộ nhớ trong NPU, DRAM và flash. Hãng nhấn mạnh đây là nền tảng để hiện thực hóa AI tạo sinh trên smartphone với tốc độ phản hồi nhanh hơn, đồng thời tăng cường bảo vệ dữ liệu cá nhân.
Cách tiếp cận đưa dữ liệu đến gần nơi xử lý hơn cũng được Qualcomm áp dụng cho CPU, nhằm hỗ trợ các tác vụ cần luân chuyển dữ liệu nhanh như chơi game, chỉnh sửa video và đa nhiệm. Ông Chris Patrick cho biết FlexCache trên CPU Oryon mới cung cấp vùng bộ nhớ đệm L2 dùng chung cho toàn bộ 8 lõi và phân bổ tài nguyên động theo nhu cầu. Ông nói thêm rằng AI agent hiện liên tục chuyển tác vụ giữa các lõi CPU trong quá trình suy luận, truy tìm ngữ cảnh và gọi công cụ, và FlexCache giúp quá trình chuyển đổi này diễn ra nhanh hơn.
 Suk Dae-geon
d2dg@d-today.co.kr