
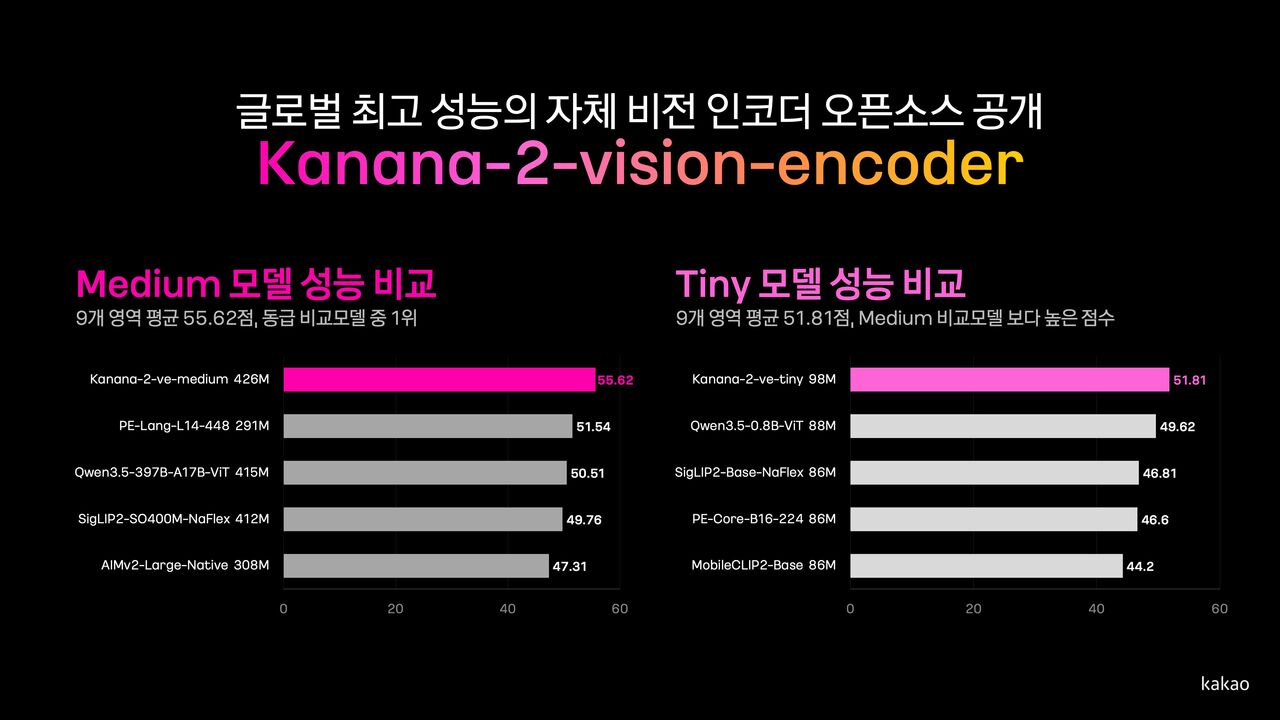
Kakaoは10月21日、独自開発のビジョンエンコーダー「Kanana-2 Vision Encoder」2モデルをHugging Faceで公開した。公開したのは「Medium」と「Tiny」で、研究・開発用途に加え、商用利用も可能な「Kanana Open License」を適用する。
今回公開したのは、4億2600万パラメータ規模の「Medium」と、9800万パラメータ規模の「Tiny」。同社は10月13日に開催した「if(kakao)26」で、公開方針を明らかにしていた。
ビジョンエンコーダーは、画像内の物体や文字、位置、形状といった視覚情報を抽出し、言語モデルに受け渡す中核技術だ。メニューや文書の読み取り、写真内の状況把握など、マルチモーダルAIにおける画像理解を担う。
Kakaoは、一般的な視覚質問応答(VQA)、英語・韓国語の文字認識(OCR)と文書理解、画像内の位置推定と詳細認識など、9領域42ベンチマークで性能を評価した。
同社によると、「SigLIP 2」(Google)、「Perception Encoder」(Meta)、「AIMv2」(Apple)、「Qwen3.5-ViT」(Alibaba)など、比較対象とした主要な海外モデルを上回る性能を記録したという。
なかでも「Tiny」は、パラメータ数を1億未満に抑えた軽量モデルだ。Kakaoは、画像内の位置推定、韓国語ベンチマーク、韓国語OCR・文書理解の領域で比較モデルとの差が表れたと説明している。
学習面では、独自言語モデル「Kanana-2」をビジョンエンコーダーの学習に活用し、学習効率を従来比で約4倍に高めた。さらに、高解像度画像処理に合わせた設計により、主要な比較モデルに比べて処理遅延を60%以上削減したとしている。
また、知識蒸留と軽量化技術も取り入れた。これにより、「Medium」に加え、オンデバイスでの活用を想定した「Tiny」も開発した。
Kakaoは、ビジョンエンコーダーのほか、言語モデル、視覚・音声処理モジュールなど、オムニ言語モデル「Kanana-o」を構成する技術を自社開発している。今後は、ほかの構成要素についても順次公開する予定だ。
Kakao Unified Foundation Modelの成果リーダーであるノ・ビョンソク氏は、「コンピュータ画面を直接理解して操作するコンピュータユース技術への関心が高まるなか、高解像度画像を正確に分析するビジョンエンコーダーの役割も大きくなっている」とコメント。「自社AIモデルの競争力を高めるとともに、関連技術の公開も継続していく」と述べた。
 Ho-jung Lee
lhj@d-today.co.kr