
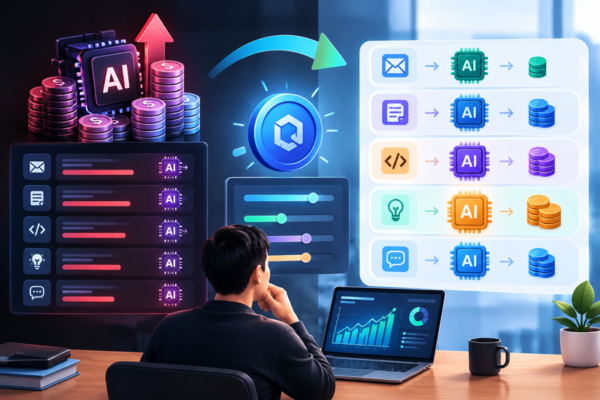
最上位のAIモデルは小型モデルに比べてトークン単価が最大100倍高い。それにもかかわらず、企業や利用者の間では、メール作成や要約といった比較的単純な業務にも高性能モデルを広く使うケースが目立っている。AIエージェントや自動化ツールの普及でトークン消費が急増するなか、業務ごとのモデル選定と利用量の統制が、AIコスト管理の重要課題になっている。
Decryptが10月17日(現地時間)に報じたところによると、Metaの従業員は今年初めの30日間で計60兆トークンを消費した。社内でAI利用量のランキング化が進み、競争が過熱したことが背景にあるという。
技術コラムニストのゲルゲイ・オロスは、Anthropicの定価を基準に、この利用規模を約9億ドル(約1350億円)相当と試算した。ただし、あくまで定価ベースの推計であり、Metaの実際の支払額はこれを下回る可能性がある。
こうしたAI利用量を競う動きは、ほかの大手テック企業でも見られる。Meta、Amazon、Uberなどでは、従業員のAIツール利用量を比較する社内ランキング表が運用されていたとされる。Uberは2026年のAIツール予算を約4カ月で使い切ったという。
NVIDIAのCEO、ジェンスン・フアン氏もAI活用の拡大を後押ししてきた。フアン氏は3月、ポッドキャスト「All-In」で「年俸50万ドル(約7500万円)のエンジニアが、少なくとも25万ドル(約3750万円)相当のトークンを使っていなければ非常に懸念する」と語った。生産性向上を狙ったAI利用の奨励が、結果として利用量競争を招き、コスト管理の負担を増やしているとの見方もある。
背景にあるのは、AIモデル間の価格差の大きさだ。AnthropicとOpenAIの最上位モデルは、最小クラスのモデルと比べて、トークン当たりの価格が最大100倍に達する。
OpenAIでは、入力100万トークン当たり10ドル(約1500円)のモデルがある一方、0.10ドル(約15円)のモデルもあり、価格差は極めて大きい。
トークンは、AIがテキストを処理・生成する際の基本単位だ。利用者が入力する質問や文脈だけでなく、AIが返す回答にもトークンが使われる。
月額20ドル(約3000円)前後のサブスクリプションでは、トークンの消費ペースが利用上限に影響する。API経由でAIを利用する企業では、使用量の増加がそのまま請求額の増加につながる。
Bain & Companyのジュエ・ワン氏は、企業がメール作成のように複雑な推論を必要としない業務でも、最上位モデルを使うケースが少なくないと指摘する。実質的に、あらゆる作業にAnthropicの高性能モデル「Opus」を当てるような運用だという。
Amazon社内でも同様の問題が起きた。一部の従業員が、業務との関連が薄い作業にも社内AIツールを使い、利用実績を積み増していたとされる。
これを受け、ある上級副社長は従業員に対し、「使うこと自体を目的にAIを使うな」と警告した。利用量そのものを成果のように扱えば、実際の生産性向上を伴わないまま、コストだけが膨らみかねないためだ。
コストを押し上げる別の要因として、AIエージェントと、複数エージェントを束ねるオーケストレーションの広がりもある。AIエージェントは、検索やコード実行、結果のレビューなど複数の工程を経てタスクをこなす。
この過程で、過去の会話や作業文脈を何度も受け渡すと、トークン消費は膨らみやすい。さらに、複数の下位エージェントに処理を分担させるオーケストレーションでは、呼び出し回数と文脈処理量が一段と増える可能性がある。
Anthropicは「Claude Code」について、チームベースのエージェントが計画モードで動作する場合、通常のセッションより約7倍多くのトークンを消費する可能性があると説明している。エージェントが複雑な業務を自律的に処理するほど、利用者が直接入力しなくても、バックグラウンドで発生するトークン消費は増えやすい。
コスト削減策の第一は、業務の難度に応じてモデルを使い分けることだ。メール作成や文章校正、簡単な要約は小型モデルに任せ、複雑な推論や重要な意思決定など高い精度が求められる業務に限って最上位モデルを使う方法が考えられる。
実務では、直近の業務を数件抽出し、高性能モデルと小型モデルの双方で結果を比較する手法も有効だ。小型モデルで要件を満たせると判断できれば、その業務では継続的に小型モデルを使う。Decryptは、こうしたモデル分岐の戦略によってAPIコストを最大99%削減できる可能性があると紹介している。
もっとも、実際の削減率は業務の種類やモデル価格、使用量によって変動する。
プロンプトと文脈の管理も重要だ。質問を何度も修正しながら回答を補わせるより、最初から必要項目や出力形式を具体的に指定したほうが、不要なやり取りを減らせる。話題が切り替わる場合は新しい会話を始め、過去の文脈を繰り返し引き渡す状態を避けるのも有効だ。
Anthropicは、長い会話の継続によって関連性の低い情報が蓄積し、回答品質が落ちる現象を「context rot(コンテキスト腐敗)」と説明している。文脈が長くなると、処理すべきトークンが増えるだけでなく、重要な情報に焦点を当てにくくなるという。
回答の長さを制限することも、直接的なコスト削減につながる。AnthropicとOpenAIの最上位モデルでは、出力トークンの価格が入力トークンの5倍に設定されている。
そのため、「100語以内で回答せよ」「修正箇所だけを出力せよ」といった指示を加えれば、不必要に長い出力を抑えられる。
計算や集計まで、すべてをAIに任せる必要はない。長い表全体を入力して分析させるより、必要な数式や短いスクリプトだけを作成させ、自分で実行したうえで計算結果のみをAIに渡すほうが効率的な場合もある。
反復計算をモデルの推論過程に載せるのではなく、一般的なツールで処理することで、トークン消費を抑えるという考え方だ。
開発環境では、キャッシュとバッチ処理も有力なコスト削減策になる。繰り返し使うシステム指示や固定的な文脈をキャッシュ化すれば、同じ内容を毎回入力するコストを削減できる。
OpenAIとAnthropicは、バッチ処理に50%の割引条件を提示しており、リアルタイム応答が不要な大量処理に活用できる。
例えば、請求書1000件を1件ずつリアルタイムで処理するのではなく、バッチ処理でまとめれば、呼び出しコストを抑えられる可能性がある。ただし、キャッシュやバッチ処理は、適用条件や対応できる業務タイプの確認が前提となる。
AIエージェントには、実行ステップ数と支出上限を設定すべきだ。開始前に完了条件を明確にし、最大実行ステップとドル建ての予算を指定しておけば、エージェントが改善を目的に不要な作業を繰り返す事態を防ぎやすい。
Shopifyは、1日の支出が急増した場合に、開発者のアクセスを即時遮断する仕組みを運用していると伝えられている。
注目すべきなのは、トークン単価が下がる一方で、総支出はむしろ増えている点だ。Silicon Dataのトークン支出指数によると、トークン当たりの価格は2023年以降に90%超下落したが、LLM関連支出は2025年末以降で2倍に増えた。
Bain & Companyは、2024年12月から2025年にかけてトークンコストが半減する一方、使用量は450%増えたと分析している。
これは、AIモデルの単価下落がそのまま総コストの減少を意味しないことを示している。単価が下がっても、それを上回るペースで利用量が増えれば、企業の支出総額はかえって膨らむ。
AIコストの抑制は、単に安価なモデルを選べば済む話ではない。業務ごとに適切なモデルを割り当て、プロンプトと文脈を効率的に管理し、エージェントの反復実行と支出を統制する運用体制が欠かせない。AI導入競争が「どれだけ使うか」から「どれだけ生産性を高められるか」へ移るなか、企業の焦点もまた、「使用量」ではなく「利用効率」に移りつつある。
 Jinju Hong
hongjj@d-today.co.kr