
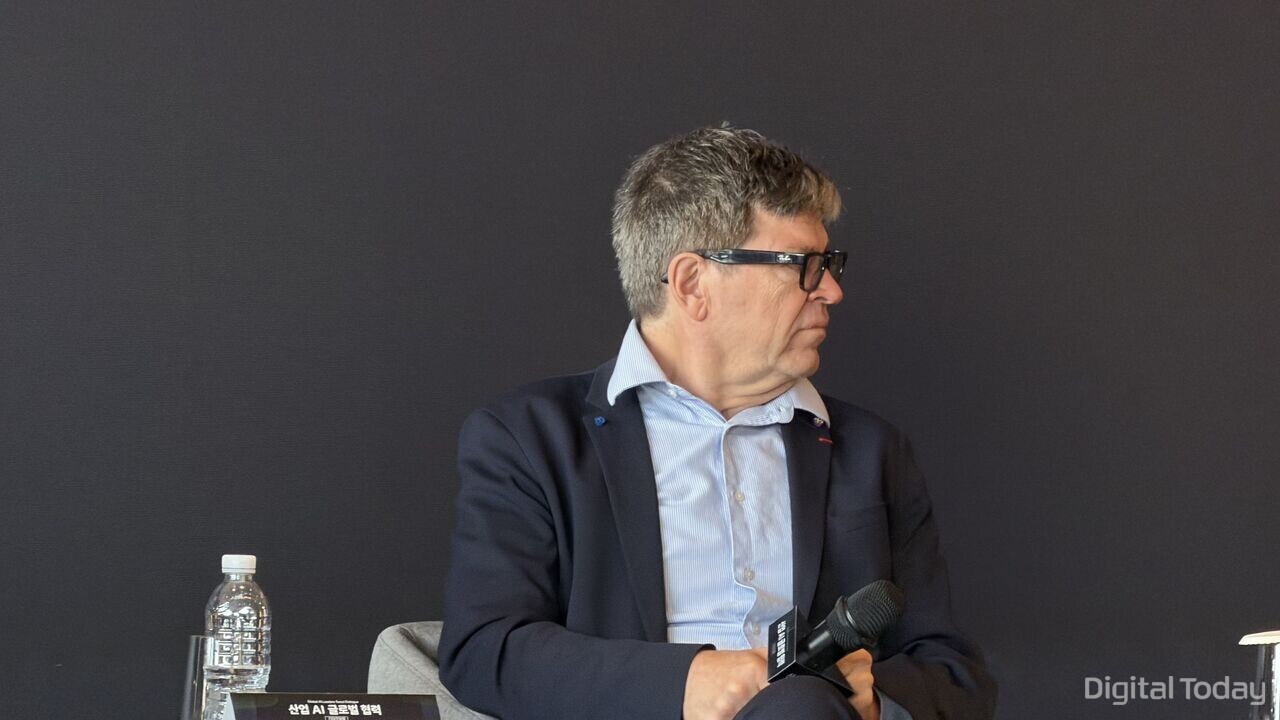
AI研究の第一人者でAmi Labs会長のヤン・ルカン氏は10月12日、AIが人間の制御を離れて暴走するとの見方について、「SFに近いシナリオだ」と否定した。現在主流の大規模言語モデル(LLM)を中心とする安全対策には限界があるとし、World Modelのような新たな設計と技術的な安全機構によって、AIの制御性を高められるとの考えを示した。
ルカン氏は、ソウル市中区のウェスティン朝鮮ホテルで開かれた「産業AIグローバル協力」記者懇談会で、AIの危険性と制御可能性に関する質問に答える形でこうした見解を述べた。
同氏は「誰かが人間レベルの知能を実現する秘密を発見し、突然ロボットが世界を支配するというのは、SFに近いシナリオだ」と指摘した。その上で、「技術の進歩は、複数の革新やブレークスルーが積み重なる漸進的なプロセスだ」と語った。
最近のAIエージェントを巡るセキュリティ事故についても、問題はAIそのものよりシステム設計にあるとの認識を示した。
ルカン氏は「最近の事故は、AIエージェントを導入した企業側の不注意によるものだ」とした上で、「サンドボックス(隔離実行環境)など既存の技術を適切に適用していないことが問題であり、十分に対処可能だ」と説明した。
一方、現在主流のLLMベースのAIシステムについては、構造上、制御が難しいとの見方を示した。
「想定されるあらゆる問いに対応させ、安全な応答を返すよう調整するのは現実的ではない」と述べ、「LLMベースのAIは、意図しない回答を生成するよう誘導することも比較的容易だ」と指摘した。
その代替案として示したのが、World Modelを活用する「目標志向AI(Objective-driven AI)」だ。行動の結果をあらかじめ予測し、事前に設定した目標や安全上の制約条件に基づいて動作するよう設計する手法だという。
ルカン氏は2025年末、AIスタートアップのAmi Labsを共同設立し、World Modelの開発に着手した。World Modelは現実世界を学習し、行動の結果を予測するAI技術で、既存のLLMが抱える物理環境の理解や行動制御の限界を克服することを目指している。
同氏は「安全を確保する制約条件を設計できれば、AIシステムを本質的に安全なものにできる」と強調した。また、「容易な課題ではないが、最終的には工学的に解決すべき問題だ」と述べた。
AIの安全性確保については、航空機エンジンの設計を引き合いに出して説明した。複雑で危険性の高い技術であっても、精緻な設計と検証を重ねることで高い安全性を実現できる、との考えだ。
もっとも、World ModelベースのAIも危険性と無縁ではないとした。「AIが現実世界を誤って予測すれば、安全だと判断した行動が実際には危険になる可能性がある」と述べた。
サイバーセキュリティ分野については、AIは攻撃側より防御側に有利に働くとの見通しを示した。
ルカン氏は「これまでに示されている証拠は、AIが攻撃者より防御者に有利に作用することを示している」と述べた。
防御側は人材、資金、情報共有の面で優位に立つ一方、攻撃側は秘匿性が求められるため、協力には制約があると説明した。長期的な影響については、不確実性が残るとも付け加えた。
 Seulgi Son
sageson@d-today.co.kr