
VesslAIは10月12日、Upstageの大規模言語モデル(LLM)「Solar Pro 4」に推論インフラを提供すると発表した。GPUリソースとサービング構成の最適化を通じて、処理能力の向上とトークン当たりコストの削減を支援する。
今回の協業についてVesslAIは、韓国で開発されたAIモデルのグローバル展開を、同じく韓国企業のインフラが支える事例だとしている。
VesslAIは、モデルの特性と実際のトラフィックパターンに合わせてGPUリソースを構成し、サービングインフラを最適化した。これにより、処理能力を高めながらトークン当たりコストの圧縮を進めたという。
あわせて、キャッシュヒット率の改善やモデルの量子化、推論高速化技術も適用した。エンドポイント導入前後の比較では、処理速度が平均で2倍、最大で3倍に向上したほか、キャッシュヒット率の改善によってトークン当たりコストを引き下げ、最大2倍のコスト削減効果を実現したとしている。
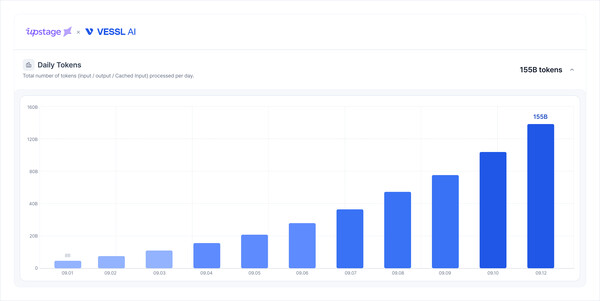
また、VesslAIは「Solar Pro 4」の1日当たりトークン処理量を80億から1550億へ拡大する取り組みも支援したという。
今後も同社は、Solarモデルの利用拡大に必要な推論インフラの支援を続ける方針だ。
アン・ジェマン代表は「今回の協力は、韓国で開発されたモデルのグローバルな成果を韓国のインフラで支えた点で意義が大きい」とコメントした。そのうえで、「これまで蓄積してきた推論運用の知見を基に、モデル提供者が研究と製品開発に集中できる環境を整える。企業によるオープンソースモデル導入を安定して支援できるよう、推論プロバイダーとしての能力を強化していく」と述べた。
著者について
 Chi-gyu Hwang
delight@d-today.co.kr