
AMD正加快与韩国AI芯片企业的合作布局,并将开放生态作为切入点。市场关注的焦点在于,韩国AI基础设施能否逐步摆脱对Nvidia GPU的单一依赖,转向由AMD GPU与国产NPU共同支撑的多元化算力格局,并进一步向涵盖模型、芯片、软件和基础设施的“全栈主权AI”延伸。
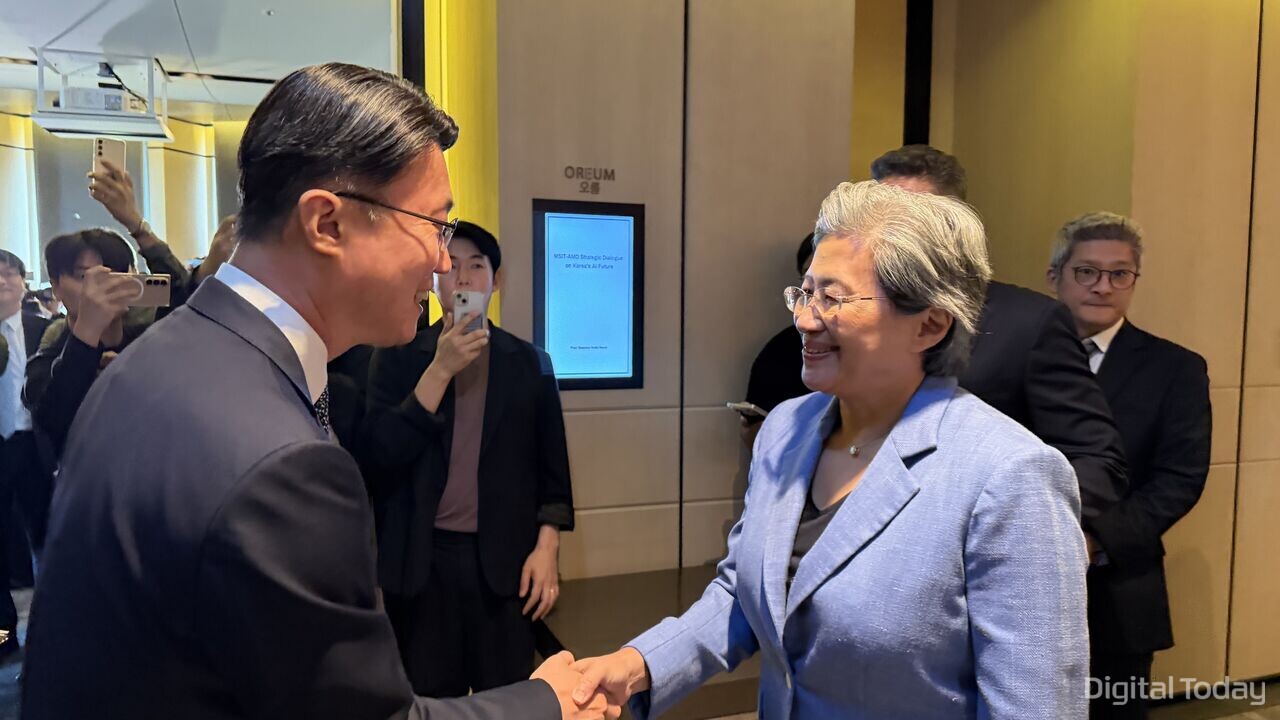
韩国科学技术信息通信部与AMD于7日在首尔钟路区四季酒店举行“AI芯片与创业公司圆桌会”,围绕异构计算生态建设并与韩国企业展开讨论。
共有13家韩国企业参加当天会议,覆盖NPU、软件、云和AI模型等AI基础设施全链条,包括FuriosaAI、HyperAccel、DeepX、Mobilint、Mangoboost、Panmnesia、Dinoticia、MOREH、Nota AI、Rablup、FADU、ELICE Group和Upstage。
韩国科学技术信息通信部第二次官Ryu Je-myeong在开场致辞中表示,随着AI重心转向推理,行业不应继续依赖单一芯片,而应根据服务类型和使用目的灵活调配不同计算资源,异构AI计算的重要性正在不断上升。
他还指出,AMD正基于开源与标准持续扩大开放生态,这将为韩国企业带来新的合作机会。
双方还讨论了异构计算基础设施建设方案,即将AMD的CPU、GPU与国产AI芯片结合,并将其打造为可在全球市场推广的参考方案。
Lisa Su也将开放生态与协作列为AMD的核心原则。她表示,过去6个月AI领域发展迅速,AMD始终坚持开放生态和合作模式。AMD已经与部分参会企业展开合作,希望借由当天的交流进一步深化协作。
她还表示,若要推动AI前沿发展并扩大AI在全球范围内的应用,开放生态不可或缺。AMD将进一步梳理韩国初创企业的技术能力,以及AMD可提供支持的合作方向。
从“非Nvidia不可”走向异构计算
在业内看来,AMD此次扩大在韩合作,意义并不只是“用AMD GPU替代Nvidia GPU”。
随着AI服务从训练快速转向大规模推理,行业更倾向于针对不同工作负载组合使用GPU、NPU等各类加速器,而不是将所有计算任务都集中在单一高性能GPU上。
这也意味着国产NPU企业可能迎来新的市场空间。目前,多数韩国AI芯片企业更聚焦推理,而非超大模型预训练。但随着Agent AI扩散、推理需求持续增长,推理基础设施本身正走向大规模化,相应应用空间也在扩大。
Rablup CEO Shin Jeong-gyu在座谈会前接受记者采访时表示,AI市场扩张速度远快于Nvidia、AMD等企业能够全面覆盖的速度。各家公司在进行“选择与聚焦”时,市场必然会出现空白地带。
他表示,随着高性能GPU进一步转向超大规模、高附加值市场,现有数据中心GPU的替换需求,以及更重视能效的推理市场,都可能成为国产NPU的新机会。
Shin Jeong-gyu预计,从明年起,H100等GPU的部分应用场景将出现替换需求。对于能够补足相近性能的NPU企业而言,这将是明确机会。他还指出,编码、Agent AI以及中等规模模型编排等用例增多,再加上越来越多企业出于数据安全考虑建设边缘基础设施,也可能带动国产NPU需求上升。
从推理延伸至训练,“全栈主权AI”能否落地
接下来的关键,在于国产AI芯片的角色究竟能扩展到何种程度。
目前,韩国企业实现商业化的NPU大多集中在推理环节。超大AI模型预训练几乎仍建立在以Nvidia为中心的GPU生态之上。如果要实现覆盖模型与算力基础设施的“全栈主权AI”,训练芯片能力仍是必须补齐的短板。
预训练是利用海量数据从零构建AI模型基础能力的过程,对算力资源需求极高。相比之下,后训练主要是围绕已完成预训练的模型,通过微调或强化学习(RL)等方式按特定目标进行优化,所需算力规模相对较小,因此被视为国产NPU从推理迈向训练的现实切入点。
当前业内讨论较多的路径是,先在推理和后训练环节提高国产NPU使用比例,再逐步向预训练扩展。
FuriosaAI CEO Baek Jun-ho表示,韩国是全球少数具备“半导体全栈”能力的国家之一,从根本上具备实现这一目标的条件。当前数据中心推理市场占比较大,因此企业首先聚焦推理,但从技术角度看,未来也可以延伸至预训练。
在他看来,随着大规模集群推理需求增加,推理用NPU积累的技术和基础设施经验,有望成为后续进入训练领域的基础。
他还建议,将韩国政府计划于明年投入4.7万亿韩元推进的前沿AI模型开发项目,作为国产NPU的测试平台。通过政府机制降低初期导入的试错成本,并积累可用于真实AI模型开发的参考案例。
Baek Jun-ho强调,国产NPU首次用于训练时可能会经历一定试错,因此政府有必要承担测试平台角色:模型开发仍以GPU为中心,但可先在后训练环节导入国产NPU,再根据实际成果逐步扩大到预训练阶段。
政府启动“全栈”验证,明年将建设国产NPU大规模参考案例
韩国政府也计划推动国产NPU在真实AI基础设施中落地,并于明年建设大规模参考案例。与以往仅在芯片层面进行导入和验证不同,新方案将CPU、GPU、NPU、Compute Express Link(CXL)以及软件整合为一个系统,对整体性能和互操作性进行验证。
韩国科学技术信息通信部信息通信政策室室长Lee Do-gyu在当天的背景吹风会上表示,过去国产NPU多以芯片形态供货,这在一定程度上限制了其全球化推进。明年,政府将规划大规模参考案例建设项目,把CPU、GPU、CXL和软件一并纳入“全栈”框架进行验证。
他表示,该项目不会以单一课题方式推进,而是将公开征集多个项目,由企业根据各自技术和服务特点组成财团参与。
在前沿AI模型开发项目中,政府也将为国产NPU预留应用空间。对于“在后训练或推理环节使用国产NPU,以形成参考案例”的方案,Lee Do-gyu表示,相关部门将在项目推进过程中一并研究,但具体使用方式和占比尚未敲定。
与AMD的合作,也与上述方向形成呼应。韩国政府计划将AMD CPU、GPU与国产NPU结合,在提升成本效率和能效的同时,同步建设支撑这一体系的软件生态。
Lee Do-gyu表示,未来关键在于如何对CPU、GPU和NPU进行优化组合,以尽可能低的成本实现高性能,并配套完善的软件环境。政府将支持韩国企业加入AMD开放生态,成长为面向全球市场的合作伙伴。
 Seulgi Son
sageson@d-today.co.kr