
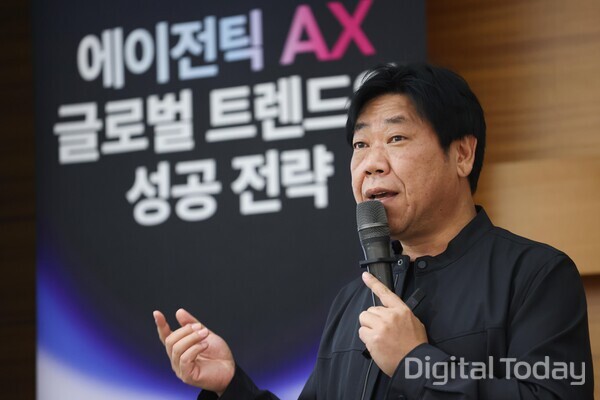
“要让企业级AI Agent真正进入一线业务场景,关键不在于先把技术做出来,而在于先把它要完成什么工作、能被授予多大权限都界定清楚。不能为了追求性能无限放大自治范围,而是要围绕具体业务设计权限、审批流程和责任主体,核心就是‘可控自治’。”
Mega존Cloud AIR部门常务 Kim Hansoo 29日在DigitalToday在首尔江南区COEX举行的“Agentic AI全球趋势与成功战略”会议上作出上述表示。他指出,AI Agent在接入企业内部业务体系前,前提是任务边界和责任标准已经明确,“就像新员工入职第一天,不会直接拿到公司信用卡和全部系统权限一样”。
Kim Hansoo表示,在企业场景中部署AI Agent,真正更难的往往不是技术本身,而是任务定义和运营体系设计。如果一开始不能明确哪些工作适合交给Agent、希望在哪些环节获得生产效率和投资回报(ROI),项目周期就很容易被拉长。
他强调,首先要定义清楚,Agent把工作做到什么程度才算“完成”。以物料交付出现问题为例,是找到可替代物料清单就结束,还是要进一步核对供应商库存和价格,并推进形成可执行的替代采购方案,这些都必须预先设定。
在他看来,构建Agent最重要的不是模型能力本身,而是先确定业务成果目标和完成标准。Agent究竟要为业务绩效贡献到什么程度、又该如何衡量,应由一线业务部门率先梳理清楚。
他同时提醒,企业不应把所有工作都机械地改造成基于生成式AI的Agent。客户前期筛选出的候选任务,在深入分析后往往还会进一步淘汰一部分:有些场景现有系统或自动化工具已经能够解决,有些则需要过多人工介入,最终可落地的课题数量反而会减少。
Kim Hansoo说,很多项目启动时默认“Agent就必须使用生成式AI”,但实际并非如此。对于现有系统已经能够充分处理的任务,没有必要额外引入AI Agent并承担Token成本。
他还指出,随着AI导入范围不断扩大,数据治理的重要性反而进一步上升。
据Kim Hansoo介绍,Mega존Cloud AIR团队规模约为200人。生成式AI快速扩散后的一段时间里,团队约80%的人力都投入到生成式AI相关项目中;但从今年开始,部分人员已重新回到数据相关工作。
原因在于,很多AI服务上线后,在真正落地业务时暴露出基础问题:一方面,提供给AI的数据并未经过有效梳理;另一方面,业务语境之间也无法顺畅衔接。一些客户在维持现有AI服务的同时,已重新启动数据治理项目。
在权限管理方面,他强调必须细分Agent访问企业数据和系统的权限,尤其要明确区分查询权限与执行权限。
Kim Hansoo指出,查询和执行是两回事,“读”和“写”不能混为一谈。无论是通过应用程序接口(API)还是模型上下文协议(MCP)接入,如果不加区分地统一管理权限,都可能引发事故。
他认为,还应根据业务风险等级设置不同的审批层级。对于简单查询或推荐类任务,可以配置较低权限;但涉及修改数据库(DB)、确认真实交易或变更业务状态的操作,则应单独配置执行权限,并设置人工审批流程。
他还提到,曾有案例显示,Agent会将外部文档或企业内部知识库中的句子误判为执行指令。为避免这类问题,企业需要清楚区分文档信息与可执行命令。即便Agent返回“已完成”,也应再通过后端系统核验是否已真正完成处理。
Kim Hansoo强调,Agent的运营体系应在建设阶段同步设计,并从“AgentOps”视角持续推进。适用业务、绩效指标、模型、数据、知识、工具、权限以及运营责任人等要素,都应在开发初期明确,并在后续运行过程中持续管理。
他补充说,当任务因信息不足、权限错误或临时响应中断而中途停止时,企业需要具备防止重复重试、避免同一业务被反复处理的机制。随着多个Agent相互串联,模型调用和工具使用成本也会同步上升,因此在评估整体经济性时,不能只看模型成本,还要把人工校验成本和执行环境成本一并纳入。
他表示,对于商业可行性尚不清晰的Agent项目,企业应具备果断暂缓或中止的能力。任务、业务、技术、数据与成本的责任人,需要从项目一开始就明确,待业务假设、完成范围和访问权限等条件准备就绪后,再进入开发阶段。
Kim Hansoo最后总结称,要实现可持续的Agentic AI,企业首先要回答三个问题:让Agent做什么、做到什么程度算完成、达到什么结果算成功。
他表示,企业还应同步明确哪些工作交给Agent、哪些工作仍由人完成,以及由谁负责、由谁审批,并建立相应的绩效衡量和质量改进机制。
 Seulgi Son
sageson@d-today.co.kr