
在OpenAI资助下,一项尝试将生成式AI用于传统统计预测的研究正在推进。其核心思路,是以GPT模拟替代研究人员手工设定的行为规则,检验AI能否更好捕捉复杂的消费者反应。
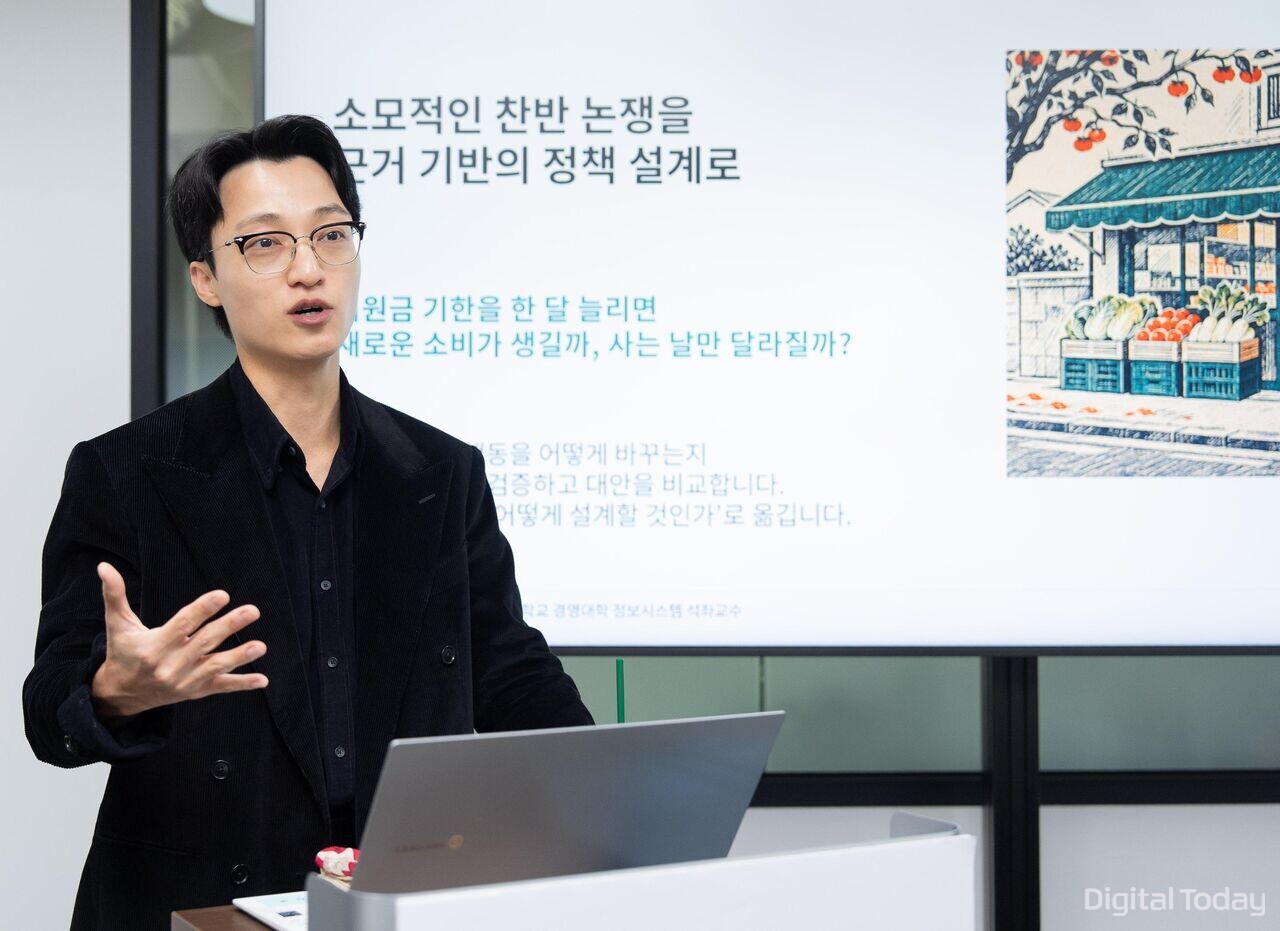
11日,在首尔江南区OpenAI Korea举行的“政策研究中的AI应用”媒体活动上,Singapore Nanyang Technological University(NTU)信息系统讲席教授 Hyukgu Kwon 介绍了这项基于大语言模型(LLM)的政策模拟研究。
Hyukgu Kwon表示,该研究旨在综合不同消费者的生活条件和消费模式,预测其对政策的预期反应,并检验预测结果与真实行为之间的吻合程度。
在现有统计预测中,常见方法之一是基于主体的建模(ABM)。这类方法通常需要研究人员根据消费者的收入、年龄、生活环境等变量,事先设定行为规则。变量越多,规则越复杂,模型受研究人员主观判断影响的可能性也越高。
目前,研究团队正利用逾100万名韩国家庭记账应用用户的金融交易数据开展GPT模拟。具体而言,团队先整理消费者的收入与支出模式,再将相关数据输入GPT,预测2025年“民生恢复消费券”发放后可能带来的消费变化;随后再将预测结果与实际交易记录、韩国银行(Bank of Korea)对政策效果的分析进行对照,以验证模型准确性。
从初步结果看,模型误差已明显下降。Hyukgu Kwon称,研究初期误差约为25%,团队一度对其可行性存疑;目前误差已降至约10%,并仍在通过不同变量组合持续迭代,以进一步提高精度。
不过,这一数据仍属于优化GPT统计预测模型过程中的阶段性指标。
Hyukgu Kwon同时指出,引入AI也带来了新的课题。虽然研究人员在规则设定上的负担有所减轻,但模型偏差的来源可能从研究人员转向GPT,本身并不存在完全无偏的模型。
他表示,研究重点并非单纯减少人工设定规则,而是转向如何向GPT提供数据、如何加工处理数据,以及应在多大程度上信任预测结果。
这类AI模拟不仅可用于政策研究,也已被应用于选举预测、市场调研等领域。Hyukgu Kwon说,在韩国,利用AI模拟补充乃至替代传统问卷样本的尝试也相当活跃。
他还强调,AI模拟的定位是为理性决策提供依据。即便在相同预算下,面向全民普发与定向支持低收入群体,模型可能得出不同的消费拉动效果,但这些结果是否会真正转化为政策,仍需额外的价值判断。
Hyukgu Kwon表示,GPT或其他AI工具无法替代基于证据作出的最终决策。研究的目标,是尽可能准确地呈现政策的预期效果,推动围绕数据展开建设性讨论。
这项研究属于OpenAI“面向智能时代的新政策构想(New Policy Ideas for the Intelligence Age)”资助计划的一部分。根据OpenAI介绍,该计划将为全球14个独立研究项目提供支持,形式包括研究经费和API额度;单个项目最高可获得价值200万美元的支持,并可使用最新前沿AI模型。
在说明资助背景时,OpenAI提到其“让全人类共享AI收益”的使命。OpenAI Korea传播负责人 Seongwon Eum 表示,个人使用AI模型当然可以获得收益,但如果将其用于政策研究并提升政策有效性,其收益将扩散到更广泛的人群。
OpenAI还表示,在遴选资助对象时,也考虑了社会影响力和公益贡献潜力等因素。在韩国,Yonsei University行政学系教授 Soonman Hong 团队的“利用AI评估民主问责与治理政策”课题也入选该计划。该研究将利用AI分析和评估国会对行政部门的制衡与监督功能等内容。
对于政策研究成果是否可能被用于AI模型开发,OpenAI方面则明确划清界限,否认存在这种可能。
此外,Hyukgu Kwon团队计划在今年年底前验证GPT统计预测模型的准确性与局限性,并在明年3月前调整发放对象、发放金额和使用期限等政策条件,继续推进不同情境下的效果比较研究。
 Seulgi Son
sageson@d-today.co.kr