
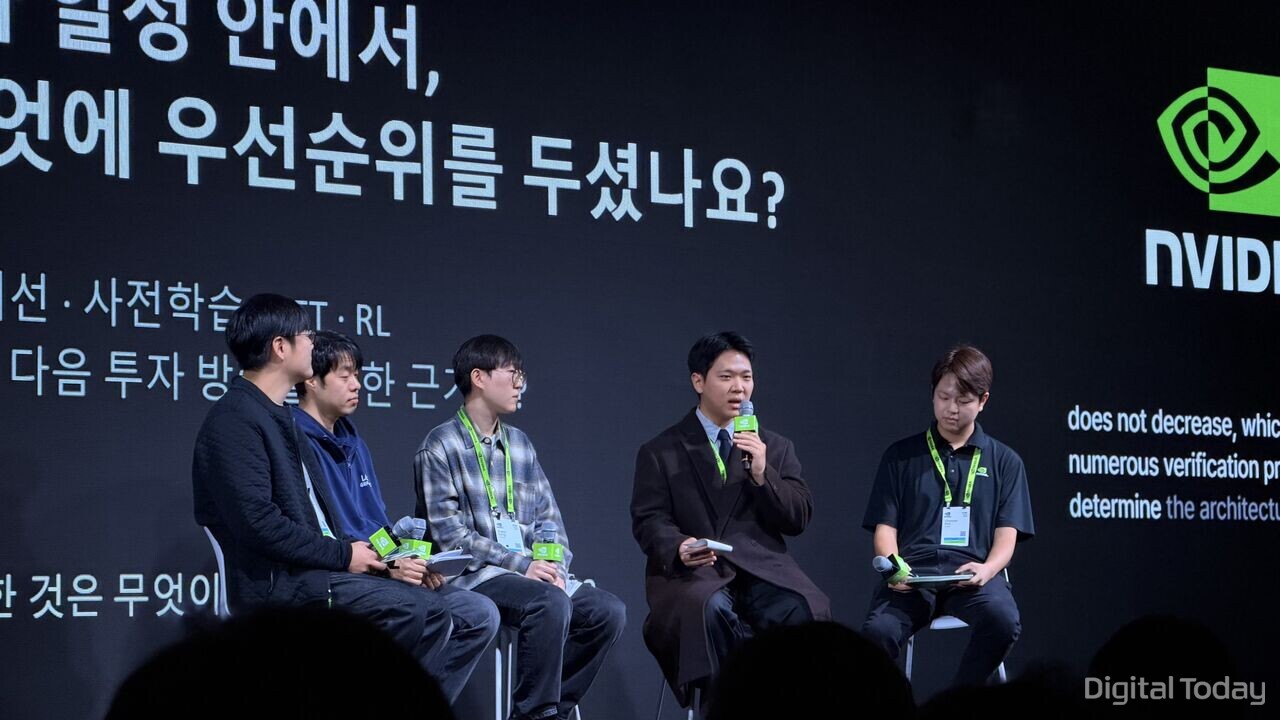
韩国入选“独立AI基础模型”项目的企业,集中介绍了其在NVIDIA平台与软件生态上的应用实践。除展示具体案例外,NVIDIA当天还同步发布了面向韩国本土AI模型的推理优化成果,进一步强化与主权AI生态的协作。
11月9日,在首尔三成洞COEX举行的“NVIDIA AI Day Seoul 2026”上,LG AI研究院、SK Telecom、Upstage等第三批入选“独立AI基础模型”的企业代表,出席“K-AI Frontier Builders”圆桌论坛并分享了相关进展。
此次交流的重点之一,是NVIDIA的AI推理优化软件Dynamo。该软件可在多台GPU服务器之间高效分配推理任务,并通过复用已有计算结果,提升处理速度和资源利用率。
Upstage表示,接入Dynamo后,AI服务运营效率明显提升,尤其是在KV缓存管理方面效果突出。KV缓存机制通过临时保存模型已完成的计算信息,减少重复计算开销。
Upstage大语言模型(LLM)技术负责人Song Inseo表示,Dynamo在KV缓存管理等环节带来的收益十分明显,能够在更少资源投入下显著提高吞吐量。
LG AI研究院也介绍了其与NVIDIA在推理优化方面的合作经验,并强调在大规模AI服务场景下,请求路由能力的重要性正在上升。
LG AI研究院EXAONE Lab团队负责人Cho Hyunjik表示,关键不在于单台服务器本身,而在于将请求路由至哪台服务器。随着服务规模持续扩大,路由能力的重要性将进一步提升。
他还表示,未来更具潜力的方向不只是单一模型,而是多模型协同编排,即在保持回答质量一致的前提下,通过多个模型协同完成响应。
除推理环节外,上述企业也在数据清洗和模型训练阶段采用了NVIDIA相关技术。
SK Telecom表示,使用NVIDIA的NeMo Curator清理AI训练数据中的重复内容后,整体数据处理周期大幅缩短。
SK Telecom研究员Yang Hyunho表示,过去处理重复数据通常需要2至3周,而借助NeMo Curator的GPU加速后,所需时间可压缩至约3天。
Yang Hyunho同时强调,训练效率与成本控制直接相关。他表示,即便模型训练速度仅提升10%,按GPU使用时长计算,也可节省约6天时间,相当于降低约6亿韩元成本。
LG AI研究院还介绍了NVIDIA Megatron Bridge的应用案例。该工具主要用于支持大型AI模型的训练与转换。
Cho Hyunjik表示,接入Megatron Bridge后,集团关联公司在使用层面更加便利,EXAONE模型的训练速度也得以提升,整体效率进一步改善。
Upstage还在使用NVIDIA的NVFP4量化技术,通过降低模型计算精度来提升处理效率。Song Inseo表示,量化可能带来一定性能损失,因此在对准确性要求较高的环节,仍会维持较高精度。
NVIDIA当天还公布了针对4款韩国本土AI模型的Dynamo优化成果,分别为SK Telecom的A.X K2、LG AI研究院的K-EXAONE 2.0、Upstage的Solar Open 2,以及Motif Technologies的Motif-3。
根据NVIDIA披露的内部测试结果,在B200 GPU环境下完成优化后,A.X K2的单GPU输出吞吐提升至原来的1.72倍,K-EXAONE 2.0提升至1.58倍,Solar Open 2提升至1.43倍;Motif-3则在独立的分布式推理环境中实现了3.67倍提升。
此外,在“NVIDIA AI Day Seoul 2026”现场,NVIDIA、SK Telecom与Rebellions三方还签署了围绕“NVLink Fusion”的合作谅解备忘录。
韩国科学技术信息通信部对上述签约表示祝贺,并与NVIDIA共同举办“AI初创企业伙伴关系论坛”。据介绍,该合作也被定位为该部门此前与NVIDIA就韩国本土神经网络处理器(NPU)协同合作所推进事项的一部分;相关论坛则旨在支持韩国AI初创企业拓展海外市场。
 Son Seul-gi
sageson@d-today.co.kr