
ElevenLabs ngày 1/10 công bố hai mô hình chuyển văn bản thành giọng nói (TTS) thế hệ mới là Eleven v4 và Eleven v4 Turbo. Trong đó, phiên bản Turbo được tối ưu cho các tác nhân AI giọng nói thời gian thực với độ trễ thấp hơn.
Theo ElevenLabs, Eleven v4 có thể tạo giọng nói dựa trên ngữ cảnh văn bản, sắc thái, nhịp điệu và đặc điểm nhân vật. Người dùng cũng có thể điều chỉnh cách phát âm, cảm xúc và hiệu ứng âm thanh bằng chỉ dẫn ngôn ngữ tự nhiên hoặc các thẻ lệnh chèn trong câu.
Số ngôn ngữ được hỗ trợ đã tăng từ 70 ở phiên bản v3 lên hơn 90. Công ty cho biết mô hình mới sử dụng cơ chế nhận diện người nói nhằm duy trì độ nhất quán của từng giọng nói qua nhiều lần tạo, đồng thời dùng các lượt thoại trước đó làm ngữ cảnh để xử lý hội thoại nhiều người.
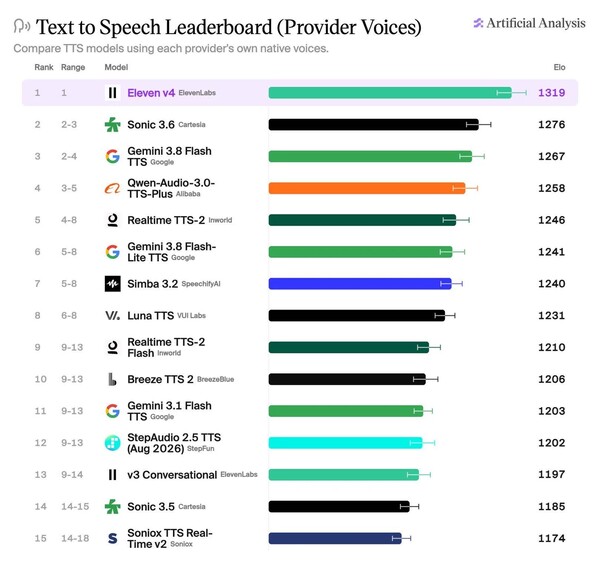
ElevenLabs cho biết Eleven v4 đứng đầu bảng xếp hạng “Provider Voice Arena” trong đợt đánh giá do tổ chức phân tích mô hình AI Artificial Analysis thực hiện vào tháng 9.
Ra mắt cùng thời điểm, Eleven v4 Turbo là phiên bản tập trung vào độ trễ thấp cho các tác nhân AI giọng nói thời gian thực. Công ty cho biết độ trễ trung bình để tạo phản hồi đầu tiên là 100 mili giây (ms). Mô hình này cũng có thể tích hợp với ElevenAgents, nền tảng tác nhân AI hội thoại của ElevenLabs.
Cả hai mô hình hiện có thể được triển khai thông qua ElevenCreative, ElevenAgents và ElevenAPI.
Maty Staniszewski, đồng sáng lập kiêm CEO ElevenLabs, cho biết các mô hình mới được phát triển cho sản xuất nội dung và tác nhân AI, nhờ khả năng biểu đạt cảm xúc đa dạng và nhận biết ngữ cảnh.
 Seulgi Son
sageson@d-today.co.kr