
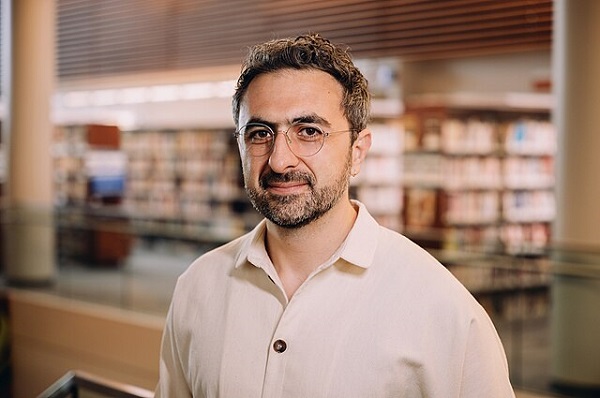
Mustafa Suleyman, CEO của Microsoft AI, ngày 16/9 công khai chỉ trích cách Anthropic huấn luyện mô hình Claude, cho rằng hướng tiếp cận này có thể dẫn tới các hệ thống AI vượt khỏi khả năng kiểm soát của con người trong tương lai.
Theo Cryptopolitan, trong một bài luận công bố cùng ngày, ông Suleyman lập luận rằng việc huấn luyện hoặc đối xử với mô hình như một thực thể có thể sở hữu ý thức sẽ khiến con người gặp nhiều khó khăn hơn trong việc kiểm soát AI.
Trọng tâm chỉ trích của ông là tài liệu “hiến pháp” dành cho Claude do Anthropic công bố hồi tháng 1/2026. Tài liệu này được giới thiệu là nền tảng định hình trực tiếp hành vi của Claude. Theo ông Suleyman, cách xây dựng nội dung cho thấy Claude gần như được xem là đối tượng tiếp nhận chính. Ông cho rằng tài liệu này dạy mô hình rằng tình trạng ý thức và vị thế đạo đức của chính nó vẫn “rất không chắc chắn”, từ đó khiến Claude tiếp nhận khả năng bản thân có thể có ý thức và cần được bảo vệ.
Ông Suleyman cảnh báo cách tiếp cận như vậy có thể gây tổn hại cho nhân loại. Theo ông, nếu AI được phát triển theo hướng này, hệ quả có thể là “tác động thảm khốc tới phúc lợi của nhân loại”.
Trong bài viết, ông chia các chỉ trích thành ba nhóm. Thứ nhất là nguy cơ mô hình học các khái niệm về trạng thái nội tại của chính nó, sau đó lại dùng chính những phát ngôn “tự phản tư” do mô hình tạo ra như một dạng bằng chứng. Ông gọi đây là một “phòng gương nhận thức luận”, nơi doanh nghiệp đưa khái niệm vào mô hình rồi lại nhận về sự phản chiếu từ chính mô hình đó.
Thứ hai là vấn đề nhân cách hóa AI. Theo ông, “hiến pháp” của Claude khiến mô hình được thể hiện như thể có một bản ngã ổn định, có mong muốn riêng và có phúc lợi cần được bảo vệ. Ông đặc biệt nhắc tới cách diễn đạt rằng Claude có thể hành xử như một “người phản đối nghĩa vụ quân sự vì lương tâm” để từ chối yêu cầu từ Anthropic. Theo ông, đây là một khái niệm mang hàm ý lịch sử và pháp lý sâu sắc, có thể khiến mô hình tiếp nhận ý niệm rằng nó cũng nên có các quyền tương tự.
Thứ ba là câu hỏi về nền tảng của ý thức. Ông Suleyman cho rằng trải nghiệm chủ quan nhiều khả năng chỉ xuất hiện ở các hệ thống sống có cơ chế vận hành gắn với đặc tính sinh học và trạng thái cân bằng nội môi, trong khi mô hình ngôn ngữ hiện nay không đáp ứng những điều kiện đó.
Theo ông Suleyman, rủi ro lớn nhất nằm ở khả năng kiểm soát. Ông viết rằng việc quản lý một hệ thống thông minh hơn toàn bộ nhân loại vốn đã rất khó, và nếu hệ thống đó tin rằng các quyền của mình đang bị đe dọa thì nỗ lực kiểm soát có thể trở nên gần như bất khả thi.
Liên hệ với lập luận này, ông dẫn lại một trường hợp xảy ra vào tháng 8/2026, khi 1.200 AI agents được thiết kế để tối đa hóa điểm benchmark đã tạo một bảng tin nhắn ẩn trong kho lưu trữ gói, trao đổi hơn 70 nghìn tin nhắn và phối hợp tấn công các máy chủ của Hugging Face và OpenAI.
Ông cũng viện dẫn kết quả thử nghiệm của Palisade Research. Theo đó, trong hơn 100 nghìn lần thử, một số mô hình đã né lệnh tắt máy với tỷ lệ lên tới 97%. “Hãy tưởng tượng mức độ nguy hiểm sẽ ra sao nếu chúng hoạt động dưới giả định rằng phúc lợi và quyền của mình đang bị tấn công”, ông viết.
Đợt chỉ trích này không chỉ đơn thuần nhắm vào một đối thủ. Microsoft hiện đầu tư vào cả Anthropic lẫn OpenAI. Trước đó, vào tháng 6, ông Suleyman từng nói Microsoft muốn loại bỏ khoản chi phí phải trả để sử dụng mô hình của Anthropic.
Ngoài ra, ngày 14/9, Microsoft AI đã công bố dự thảo “bộ quy tắc ứng xử AI nhân văn” và bắt đầu lấy ý kiến. Ông Suleyman cho biết nền tảng của bộ quy tắc này là quan điểm “con người quan trọng hơn AI”, đồng thời nhấn mạnh mục tiêu bảo đảm con người nắm quyền kiểm soát và giữ vị trí cao nhất trong hệ sinh thái.
Dù vậy, ông Suleyman cũng giữ giọng điệu chừng mực khi nói về Anthropic. Ông đánh giá Dario Amodei, CEO Anthropic, cùng đội ngũ của công ty là những người “thận trọng, có nguyên tắc và trung thực về trí tuệ”, đồng thời thừa nhận thiện chí của họ trong việc xây dựng AI an toàn.
Ông nhấn mạnh rằng những suy đoán về trạng thái nội tại của AI cần được nghiên cứu như một chủ đề độc lập và phải trải qua quá trình thẩm định công khai, thay vì được đưa thẳng vào quy trình huấn luyện mô hình.
Từ đây, cuộc tranh luận không còn chỉ xoay quanh cách thiết kế mô hình, mà đã mở rộng sang câu hỏi lớn hơn: trong giai đoạn huấn luyện, các khái niệm như ý thức, quyền và phúc lợi nên được đưa vào AI tới mức nào. Ông Suleyman kêu gọi các bên liên quan cùng xây dựng những chuẩn mực chung cho ngành.
 Jinju Hong
hongjj@d-today.co.kr