
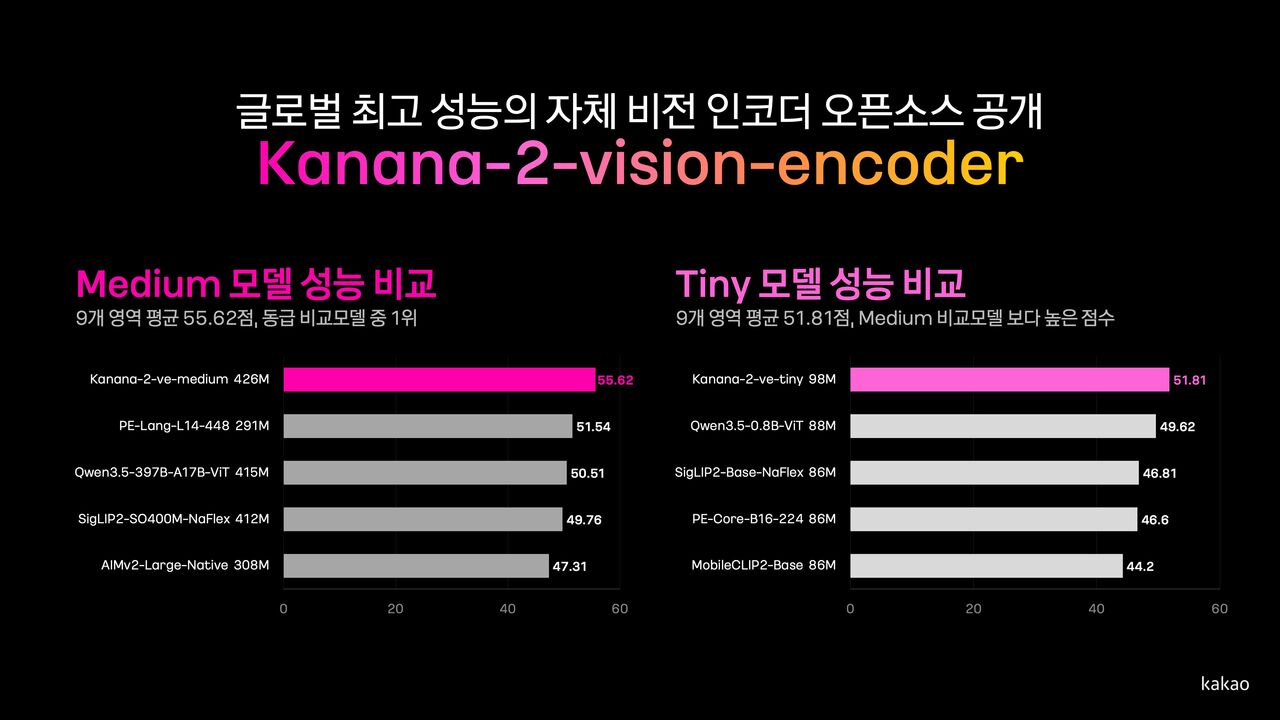
Kakao ngày 21/10 cho biết đã phát hành theo hình thức mã nguồn mở hai mô hình vision encoder do hãng tự phát triển, mang tên Kanana-2 Vision Encoder, trên nền tảng Hugging Face.
Hai mô hình gồm bản Medium với 426 triệu tham số và bản Tiny với 98 triệu tham số. Trước đó, công ty đã công bố kế hoạch phát hành các mô hình này tại sự kiện if(kakao)26 diễn ra ngày 13/10.
Vision encoder là thành phần đảm nhiệm việc phân tích hình ảnh trong hệ thống AI đa phương thức. Công nghệ này trích xuất các thông tin như vật thể, văn bản, vị trí và hình dạng trong ảnh để chuyển cho mô hình ngôn ngữ xử lý. Nhờ đó, AI có thể đọc nội dung trên menu hoặc tài liệu, đồng thời nhận diện bối cảnh trong hình ảnh.
Kakao cho biết đã đánh giá hiệu năng của hai mô hình trên 42 bộ benchmark thuộc 9 lĩnh vực, bao gồm hỏi đáp thị giác (VQA), nhận dạng ký tự quang học (OCR) tiếng Anh và tiếng Hàn, hiểu tài liệu, định vị trong ảnh và nhận diện chi tiết.
Theo kết quả tự đánh giá của công ty, cả hai mô hình đều cho hiệu năng cao hơn các vision encoder đối sánh quốc tế như SigLIP 2 của Google, Perception Encoder của Meta, AIMv2 của Apple và Qwen3.5-ViT của Alibaba.
Đáng chú ý, bản Tiny có dưới 100 triệu tham số nhưng vẫn cho kết quả vượt trội so với các mô hình đối sánh ở những hạng mục như định vị trong ảnh, bài kiểm tra tiếng Hàn, OCR tiếng Hàn và hiểu tài liệu.
Kakao cho biết đã tận dụng mô hình ngôn ngữ nội bộ Kanana-2 trong quá trình huấn luyện vision encoder, qua đó nâng hiệu quả huấn luyện lên khoảng 4 lần so với trước. Công ty cũng áp dụng kiến trúc tối ưu cho xử lý ảnh độ phân giải cao, giúp giảm hơn 60% độ trễ xử lý so với các mô hình đối sánh chủ chốt trên thế giới.
Bên cạnh đó, doanh nghiệp còn sử dụng kỹ thuật chưng cất tri thức và các phương pháp tối ưu hóa mô hình gọn nhẹ. Nhờ vậy, ngoài bản Medium, Kakao còn phát triển bản Tiny phục vụ các kịch bản chạy trực tiếp trên thiết bị.
Cả hai mô hình đều được phát hành theo giấy phép Kanana Open License, cho phép sử dụng không chỉ cho mục đích nghiên cứu và phát triển mà còn cho hoạt động thương mại.
Kakao cho biết hiện đang tự phát triển các công nghệ cấu thành omni language model Kanana-o, bao gồm mô hình ngôn ngữ, vision encoder cùng các mô-đun xử lý hình ảnh và giọng nói. Công ty dự kiến sẽ lần lượt công bố các thành phần còn lại trong thời gian tới.
Ông Noh Byung-seok, Unified Foundation Model Performance Leader tại Kakao, cho biết công nghệ computer use - cho phép máy tính tự hiểu và thao tác trực tiếp trên màn hình - đang thu hút nhiều sự chú ý. Theo ông, xu hướng này cũng khiến vai trò của vision encoder ngày càng quan trọng hơn trong việc phân tích chính xác ảnh độ phân giải cao. Kakao sẽ tiếp tục nâng cao năng lực cạnh tranh của các mô hình AI nội bộ và lần lượt công bố thêm các công nghệ liên quan.
 Ho-jung Lee
lhj@d-today.co.kr