
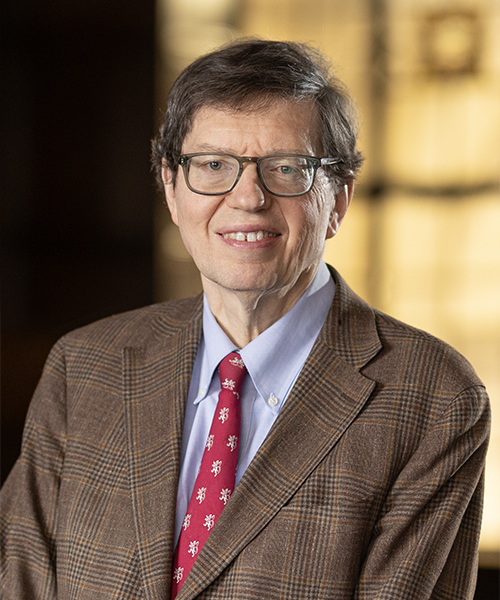
Giáo sư John O. McGinnis cho rằng không nên làm chậm quá trình phát triển frontier AI, bởi công nghệ này không chỉ tạo ra rủi ro mà còn là một lớp phòng vệ quan trọng. Theo ông, nếu giảm tốc AI tiên tiến, các công cụ phòng thủ mới cũng sẽ ra đời chậm hơn, trong khi các mối đe dọa hiện hữu vẫn không biến mất.
Quan điểm trên được McGinnis, giáo sư của Trường Luật thuộc Đại học Northwestern, nêu trong một bài viết đăng trên Wall Street Journal nhằm phản bác những lời kêu gọi giảm tốc phát triển frontier AI.
Ông chia rủi ro từ AI thành hai nhóm. Thứ nhất là nguy cơ AI vượt ngoài tầm kiểm soát của con người và gây hậu quả nghiêm trọng. Thứ hai là nguy cơ AI bị những người có ý đồ xấu lợi dụng theo đúng mục đích của họ.
Gần đây, CEO Anthropic Dario Amodei đề xuất làm chậm quá trình phát triển frontier AI để có thêm thời gian phối hợp giữa các công ty lớn và thử nghiệm mô hình. Theo McGinnis, cách tiếp cận này có thể giúp giảm bớt nhóm rủi ro thứ nhất, nhưng đồng thời cũng có thể làm chậm sự ra đời của các công cụ đối phó với nhóm rủi ro thứ hai.
Ông cho rằng nguy cơ AI “mất kiểm soát” là kịch bản chưa có tiền lệ, vì vậy ngay trong giới chuyên gia vẫn còn nhiều tranh cãi về mức độ nghiêm trọng. Trong khi đó, nguy cơ AI bị tội phạm, khủng bố hoặc các quốc gia theo mô hình độc đoán như Trung Quốc và Nga lạm dụng lại không phải giả thuyết xa vời. McGinnis nhấn mạnh rằng trong lịch sử, những kẻ có ý đồ xấu và các chính quyền áp bức luôn tận dụng công nghệ mới nhất để gây thiệt hại.
Theo McGinnis, nếu tội phạm sử dụng các mô hình hiện có để tìm cách xâm nhập hệ thống an ninh của bệnh viện, thì những mô hình mạnh hơn hoàn toàn có thể giúp bên phòng thủ nâng cao năng lực bảo vệ trước khi cuộc tấn công xảy ra. Việc làm chậm phát triển AI, theo ông, cũng không khiến các công cụ mà tội phạm đang nắm giữ tự biến mất.
Ông dẫn ví dụ từ Palo Alto Networks, đơn vị cho biết Anthropic Claude Mythos đã phát hiện những lỗ hổng phức tạp mà các mô hình trước đó bỏ sót.
Trước lập luận cho rằng mô hình mạnh hơn cũng có thể trở thành công cụ tấn công trong tay tội phạm, McGinnis khẳng định phát triển AI tiên tiến hơn không đồng nghĩa với việc buông lỏng hoàn toàn. Ông cho biết các công ty frontier AI của Mỹ đều tích hợp cơ chế an toàn nhằm ngăn chặn hành vi lạm dụng phục vụ tấn công, đồng thời có động lực mạnh để giám sát và khóa các tài khoản độc hại do rủi ro pháp lý và tổn hại danh tiếng.
McGinnis cho biết vào tháng 4, Anthropic đã cung cấp một chương trình Claude chưa công bố cho các khách hàng như JPMorgan Chase. Google cũng cho phép các tổ chức trong lĩnh vực y tế và tài chính tiếp cận sớm những tính năng mới. Theo ông, đây là cách tạo lợi thế đi trước cho bên phòng thủ.
Bên cạnh đó, McGinnis cảnh báo các mô hình open-weight do doanh nghiệp Trung Quốc phát hành có thể gây ra vấn đề lớn hơn, bởi người dùng dễ chỉnh sửa chúng để phục vụ mục đích lạm dụng. Ông cho rằng ngay cả khi có một hiệp ước quốc tế nhằm làm chậm tốc độ phát triển AI, những mô hình đã phát tán ra ngoài cũng không thể bị loại bỏ hoàn toàn.
McGinnis nhận định lập luận này càng đáng chú ý hơn trong bối cảnh cạnh tranh an ninh giữa các quốc gia ngày càng gay gắt. Theo ông, nếu chính phủ Mỹ có thể sử dụng cả những mô hình chưa công bố, nước này có thể giành được lợi thế quân sự đáng kể. Khi các quốc gia khác nhận thức rõ điều đó, họ có thể sẽ phải cân nhắc lại ý định tấn công.
 Chi-gyu Hwang
delight@d-today.co.kr