
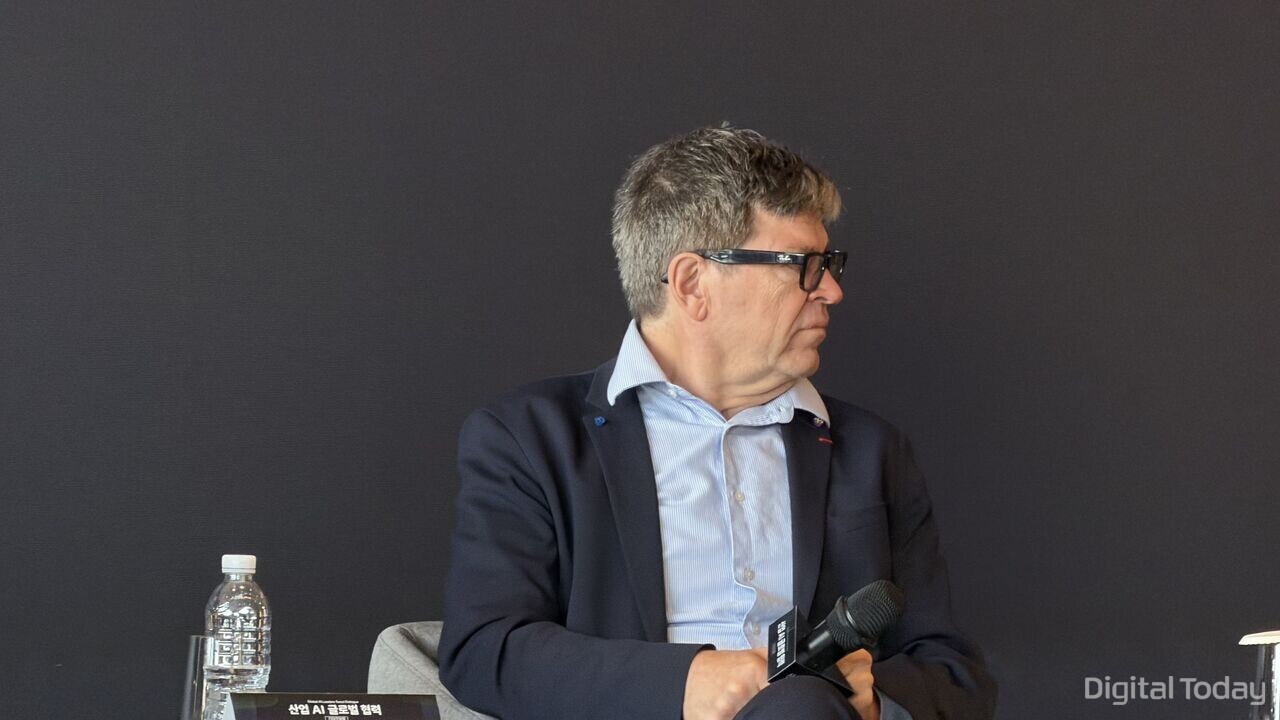
Yann LeCun, Chủ tịch AmiLabs, ngày 12/10/2026 bác bỏ lo ngại cho rằng AI có thể vượt ngoài tầm kiểm soát của con người. Ông nhận định các hệ thống AI an toàn hơn hoàn toàn có thể được thiết kế bằng những cách tiếp cận mới như world model, trong bối cảnh các phương pháp kiểm soát mô hình ngôn ngữ lớn (LLM) hiện nay vẫn bộc lộ nhiều hạn chế.
Phát biểu được ông đưa ra tại cuộc họp báo về “Hợp tác toàn cầu trong AI công nghiệp” tổ chức ở khách sạn Westin Josun, quận Jung, Seoul, khi trả lời câu hỏi liên quan đến rủi ro và khả năng kiểm soát AI.
Theo Yann LeCun, kịch bản “một ai đó bất ngờ khám phá ra bí mật tạo nên trí tuệ ngang con người, rồi robot lập tức thống trị thế giới” gần như chỉ thuộc về khoa học viễn tưởng.
Ông cho rằng tiến bộ công nghệ không diễn ra theo kiểu bùng nổ đột ngột, mà là quá trình tích lũy dần dần của nhiều đổi mới và đột phá theo thời gian.
Đề cập tới các sự cố bảo mật gần đây liên quan đến AI agent, ông nói vấn đề chủ yếu nằm ở cách thiết kế và triển khai hệ thống, thay vì ở bản thân AI.
Theo ông, những sự cố này xảy ra vì doanh nghiệp triển khai AI agent một cách thiếu thận trọng. Đây là vấn đề xuất phát từ việc không áp dụng đúng các kỹ thuật an toàn đã được biết đến, chẳng hạn như sandbox, tức môi trường thực thi cách ly, và hoàn toàn có thể khắc phục.
Ở chiều ngược lại, Yann LeCun đánh giá các hệ thống AI dựa trên LLM, vốn đang chiếm ưu thế hiện nay, có những hạn chế mang tính cấu trúc về khả năng kiểm soát.
Ông lập luận rằng việc huấn luyện AI để xử lý trước mọi tình huống có thể phát sinh, rồi tinh chỉnh để hệ thống luôn đưa ra câu trả lời không gây hại, là điều gần như không khả thi trong thực tế.
Theo ông, việc buộc một hệ thống AI dựa trên LLM tạo ra phản hồi ngoài ý muốn tương đối dễ.
Phương án thay thế mà ông đề xuất là “AI định hướng mục tiêu” dựa trên world model.
Với cách tiếp cận này, AI sẽ dự đoán hệ quả của từng hành động và ra quyết định dựa trên mục tiêu được thiết lập từ trước, đồng thời tuân thủ các ràng buộc an toàn.
Yann LeCun cho biết ông đồng sáng lập startup AI AmiLabs vào cuối năm 2025 và bắt đầu phát triển world model.
Theo ông, world model là công nghệ AI học từ thế giới thực để dự đoán kết quả của hành động, qua đó khắc phục những hạn chế của LLM trong việc hiểu môi trường vật lý và kiểm soát hành vi.
Ông nhấn mạnh rằng nếu có thể thiết kế được các ràng buộc bảo đảm an toàn, hệ thống AI sẽ trở nên an toàn ngay từ thiết kế.
“Đây không phải bài toán kỹ thuật dễ, nhưng rốt cuộc vẫn là vấn đề có thể giải bằng kỹ thuật”, ông nói.
Ông cũng so sánh việc bảo đảm an toàn cho AI với thiết kế động cơ máy bay. Theo Yann LeCun, ngay cả những công nghệ phức tạp và có rủi ro cao vẫn có thể đạt mức an toàn rất lớn nhờ thiết kế tinh vi và quy trình kiểm chứng chặt chẽ.
Tuy vậy, ông thừa nhận AI dựa trên world model cũng không hoàn toàn miễn nhiễm với rủi ro.
Ông cảnh báo rằng nếu AI dự đoán sai thế giới thực, một hành động được hệ thống đánh giá là an toàn vẫn có thể trở nên nguy hiểm trong thực tế.
Trong lĩnh vực an ninh mạng, Yann LeCun dự báo AI nhiều khả năng sẽ mang lại lợi thế cho bên phòng thủ hơn là bên tấn công.
Theo ông, các bằng chứng hiện có cho thấy AI đang có xu hướng nghiêng về phía lực lượng phòng thủ.
Ông giải thích rằng bên phòng thủ thường có lợi thế hơn về nhân lực, nguồn lực tài chính và khả năng chia sẻ thông tin, trong khi bên tấn công phải hoạt động bí mật nên bị hạn chế về phối hợp.
Dù vậy, Yann LeCun cũng lưu ý tác động dài hạn của AI đối với an ninh mạng vẫn còn là ẩn số.
 Seulgi Son
sageson@d-today.co.kr