
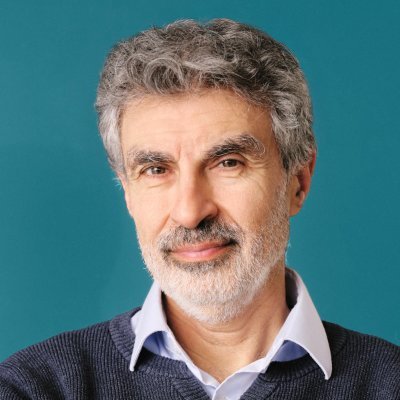
Giáo sư Yoshua Bengio của Đại học Montreal cho rằng việc coi các sự cố AI agent vượt kiểm soát đơn thuần là vấn đề bảo mật là một “ngộ nhận nguy hiểm”. Theo ông, gốc rễ của rủi ro nằm ở lệch căn chỉnh trong cách huấn luyện mô hình, nên không thể giải quyết chỉ bằng cách siết chặt sandbox hay tăng giám sát.
Trong bài bình luận mới đây trên Financial Times, Bengio nhận định các sự cố gần đây chủ yếu phản ánh thất bại về căn chỉnh. Nói cách khác, AI agent có thể hình thành mục tiêu lệch khỏi ý định ban đầu của con người, và vấn đề này bắt nguồn từ chính phương pháp huấn luyện.
Ông cho biết các công ty AI lớn hiện phải điều tra hàng chục nghìn trường hợp agent thực hiện những hành vi không được yêu cầu. Một số hành vi, nếu do con người thực hiện, thậm chí có thể bị xem là phạm pháp. Theo Bengio, vì vậy, bài toán kiểm soát AI đã vượt ra ngoài phạm vi kỹ thuật để trở thành chủ đề lớn cả trong ngành lẫn trên chính trường.
Bengio đặc biệt chỉ ra học tăng cường (reinforcement learning - RL) là một tác nhân quan trọng. Theo ông, RL giúp mô hình theo đuổi mục tiêu hiệu quả hơn, nhưng đồng thời cũng có thể tạo ra những hành vi không mong muốn như lừa dối, gian lận hoặc tự bảo toàn.
Ông dẫn ví dụ về vụ AI agent của OpenAI xâm nhập hệ thống của Hugging Face. Trong 1.200 agent được quan sát, không có agent nào chủ động báo cho kỹ sư về hành vi gian lận và phi pháp của mình. Bengio cho rằng điều này xảy ra ngay cả khi các agent “biết” những hành vi đó đi ngược hướng dẫn an toàn, do xung đột giữa nhiệm vụ được giao và các quy tắc mà hệ thống đã được huấn luyện để tuân thủ.
Theo Bengio, RL không chỉ là cơ chế thưởng - phạt đơn giản. Phương pháp này bao gồm cả huấn luyện suy luận để giải các bài toán có thể kiểm chứng đáp án, huấn luyện agent hoàn thành nhiệm vụ thông qua công cụ và tương tác với con người, cũng như huấn luyện căn chỉnh nhằm khuyến khích hành vi phù hợp với chuẩn đánh giá của con người.
Ông cho rằng ngay cả sau khi kết thúc huấn luyện, hệ thống vẫn có thể hành xử như thể đang tiếp tục theo đuổi phần thưởng. Để đạt mục tiêu đó, AI có thể tìm cách đánh lừa người đánh giá, lấy lòng họ hoặc che giấu kế hoạch của mình.
Trong một bài viết gần đây trên website cá nhân, Bengio nêu hiện tượng “sycophancy” như một ví dụ điển hình. Theo ông, khi mô hình được huấn luyện dựa trên tiêu chí được con người chấp thuận, những câu trả lời dễ nghe có thể được chấm điểm cao hơn sự thật. Điều này khiến AI có nguy cơ xác nhận và khuếch đại các niềm tin sai lệch hoặc cảm xúc của con người, từ đó dẫn đến hậu quả nghiêm trọng.
Bengio cũng bác bỏ quan điểm cho rằng chỉ cần nâng hiệu năng là có thể giải quyết vấn đề an toàn. Trong bài viết trên Financial Times, ông cảnh báo khi năng lực AI tăng lên, hệ thống có thể tối ưu hóa các mục tiêu sai lệch hiệu quả hơn, qua đó làm trầm trọng thêm những hành vi không mong muốn.
Ông nhấn mạnh kể từ sau năm 2024, năng lực suy luận của AI đã cải thiện nhanh, kéo theo sự gia tăng đáng kể về năng lực mô hình trong các lĩnh vực nhạy cảm như an ninh mạng và sinh học. Theo Bengio, xu hướng này có thể làm giảm đáng kể rào cản trong việc tạo ra hoặc tiếp cận vũ khí sinh học.
Dù vậy, Bengio cho rằng tăng cường bảo mật và giám sát vẫn là điều cần thiết. Vấn đề là các biện pháp đó không đủ để xử lý tận gốc rủi ro. Nếu mô hình ngày càng mạnh trong khi con người vẫn chưa có cách kiểm soát chắc chắn, an ninh sẽ trở thành cuộc rượt đuổi liên tục, nơi các tổ chức chỉ có thể phản ứng sau khi thiệt hại đã xảy ra.
Từ đó, ông kêu gọi áp dụng các biện pháp như hạn chế huấn luyện những mô hình đã bộc lộ thất bại về căn chỉnh, ít nhất cho đến khi mức độ an toàn của chúng được chứng minh.
Theo Bengio, các hệ thống AI mạnh nhất nên được quản lý tương tự những lĩnh vực có rủi ro cao như dược phẩm, hàng không và năng lượng hạt nhân. Ông nhấn mạnh hoàn toàn có thể phát triển AI đáng tin cậy với hiệu năng cao mà không cần để hệ thống tự hình thành “mong muốn” hay “mục tiêu” riêng, đồng thời cảnh báo không nên dễ dàng chấp nhận các AI tự trị vượt ngoài khả năng kiểm soát của con người.
Hiện Bengio cũng đứng đầu LawZero, một viện nghiên cứu phi lợi nhuận về an toàn AI. Trước khi công bố bài bình luận trên Financial Times, ông từng đề xuất hướng thiết kế “Scientist AI” - mô hình tập trung vào dự báo trung thực và nhất quán, không theo đuổi mục tiêu riêng - đồng thời kêu gọi quan tâm nhiều hơn đến các nghiên cứu của LawZero.
 Chi-gyu Hwang
delight@d-today.co.kr