
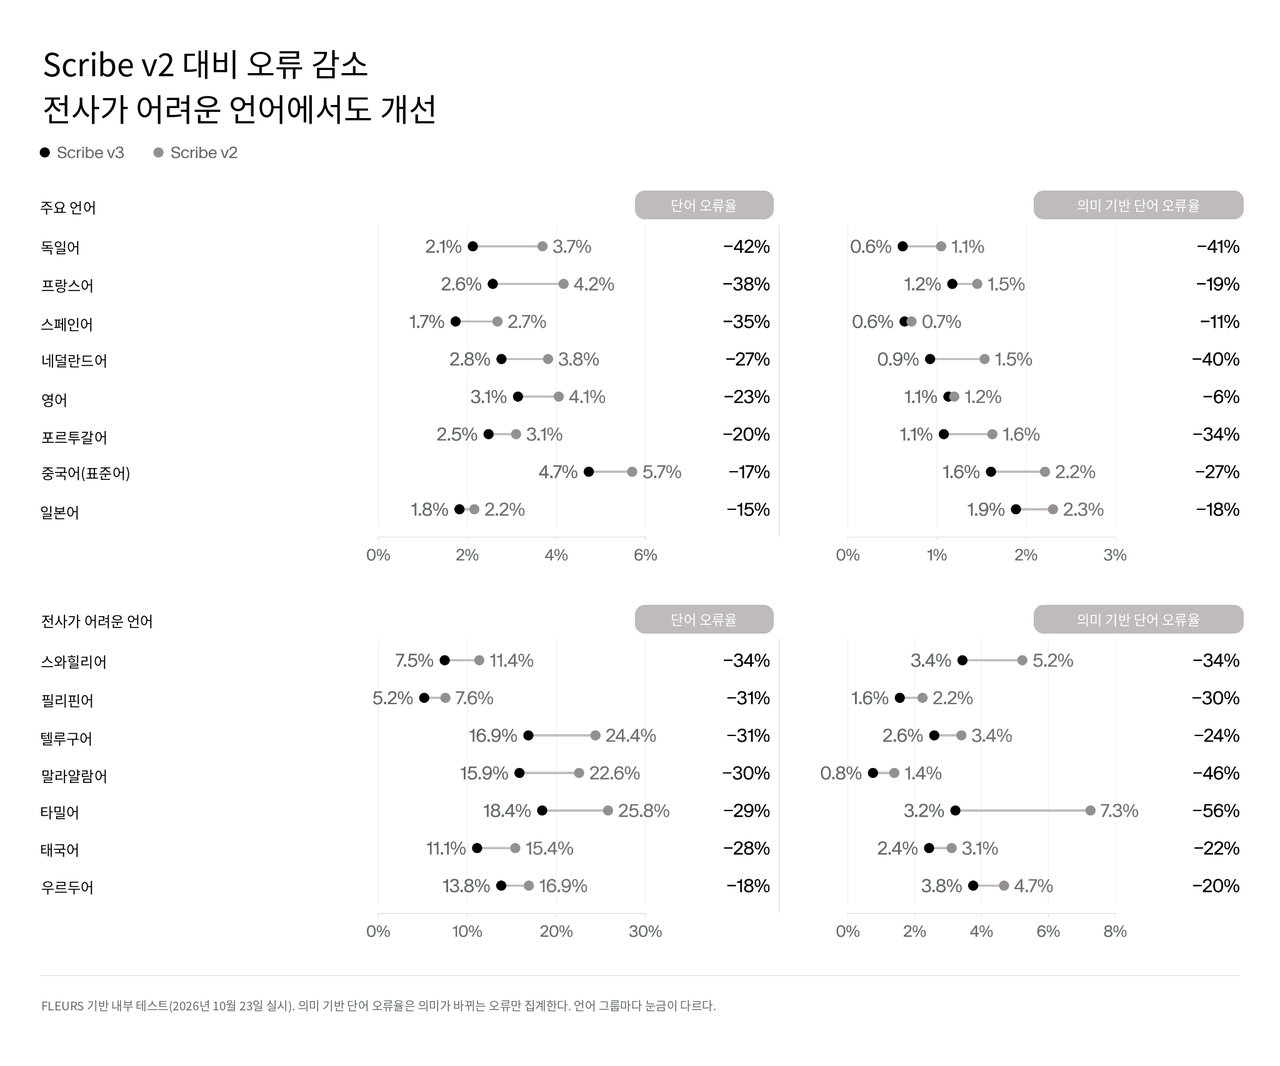
AI音频公司ElevenLabs于19日发布语音识别(STT,Speech-to-Text)模型Scribe v3和Scribe v3 Live,分别覆盖录音与实时语音场景。
据ElevenLabs介绍,Scribe v3主要面向录音场景。与上一代Scribe v2相比,该模型的词错误率(WER)下降27%。
在说话人分离方面,Scribe v3在ElevenLabs内部评测的相关模型中错误率最低。
Scribe v3 Live则面向实时语音场景。与上一代Scribe v2 Realtime相比,其错误率下降43%。同时,新版本也支持说话人分离,并进一步提升了轮次检测能力。
记者信息
 Chi-gyu Hwang
delight@d-today.co.kr
关键词
#ElevenLabs #Scribe v3 #Scribe v3 Live #语音识别 #STT #说话人分离 #轮次检测
