
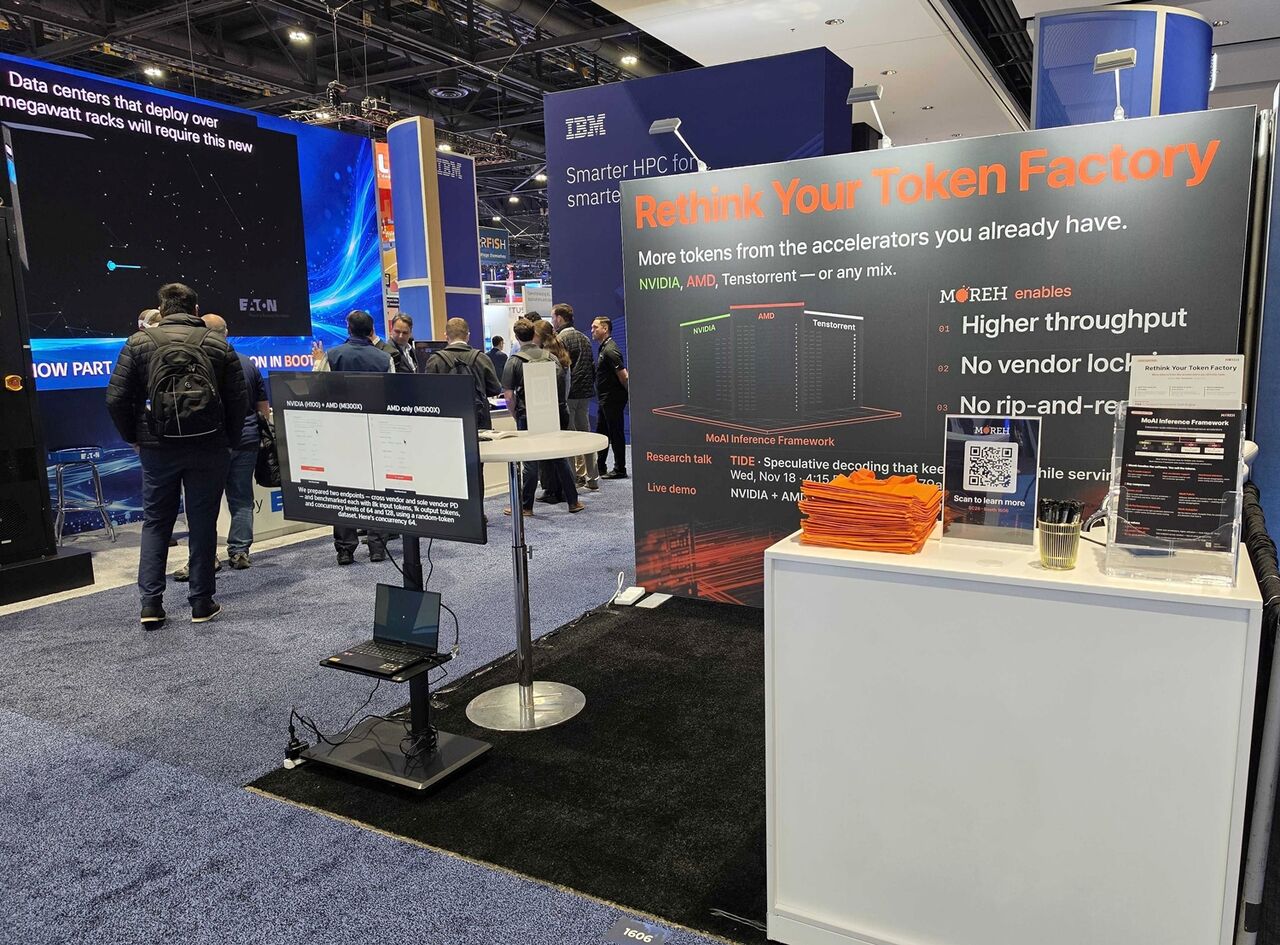
AI基础设施企业MORAI于11月20日表示,公司在美国芝加哥举行的“Supercomputing 2026(SC26)”大会上发布了大模型推理框架TIDE,旨在提升大语言模型(LLM)的推理效率。
TIDE基于实际推理过程中产生的数据,持续优化辅助模型。即使用户请求和任务类型发生变化,系统也能据此动态调整,以维持推理性能。
TIDE的核心机制是“推测解码(Speculative Decoding)”。由小型辅助模型预先预测多个token,再交由大模型一次性验证,从而提升生成速度。
传统推测解码方案在真实请求分布与辅助模型训练分布不一致时,预测准确率往往会下降,进而拖累整体性能。针对这一问题,TIDE复用大模型在推理过程中生成的内部信息,对辅助模型进行持续训练,以提高预测效果。
同时,TIDE还会实时分析辅助模型的预测准确率和性能收益,自动判断是否启用推测解码,以及是否进行额外训练,在减少不必要计算开销的同时,更好适应不断变化的任务环境。
MORAI在SC26公布的研究结果显示,相比未采用推测解码的传统方案,TIDE可将AI推理吞吐最高提升1.66倍;在无需额外生成训练数据的情况下,通过复用推理内部信息,辅助模型训练时间较现有在线学习方法最多缩短3.02倍。
公司还验证了TIDE在异构GPU环境下的性能提升。研究显示,在由NVIDIA H100 GPU负责运行大模型、AMD Instinct MI250 GPU负责训练辅助模型的配置下,系统整体吞吐较将同等GPU资源全部用于推理的方案最高提升1.22倍。
MORAI表示,这项研究基于公司在开发AI推理平台“MoAI Inference Framework”过程中积累的技术成果。同时,公司正在加快研发“Token Factory操作系统(OS)”,以便在NVIDIA和AMD GPU以及Tenstorrent AI芯片等不同加速器之间高效分配计算负载。
MORAI CEO Kangwon Cho表示,AI基础设施的竞争力不仅取决于是否拥有高性能GPU,更关键的是在既定计算资源下能够处理多少AI工作负载。公司将持续推进软件技术研发,进一步提升多样化GPU环境中的AI推理性能和资源利用效率。
 Seulgi Son
sageson@d-today.co.kr
关键词
#MORAI #SC26 #TIDE #大模型推理 #推测解码 #推理吞吐 #NVIDIA H100 #AMD Instinct MI250 #MoAI Inference Framework
