
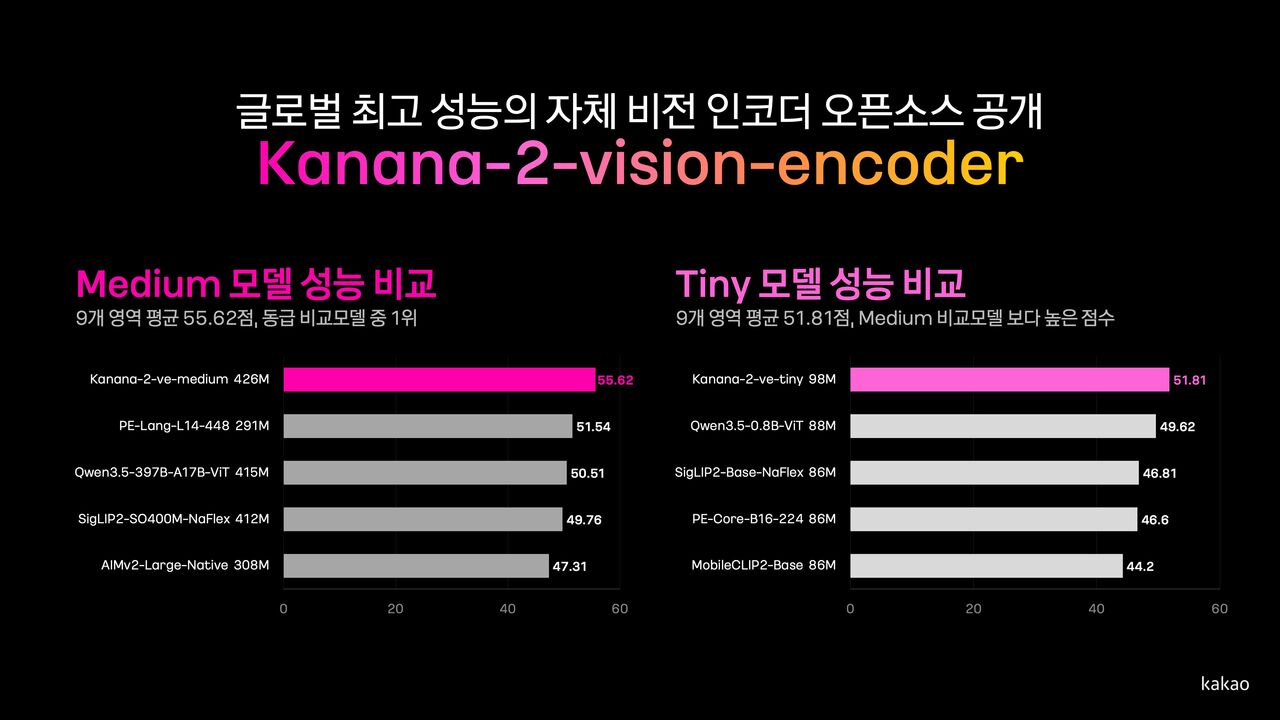
Kakao于21日表示,已在Hugging Face开源发布两款自研视觉编码器“Kanana-2 Vision Encoder”。
此次开源的两款模型分别为4.26亿参数的Medium版和9800万参数的Tiny版。Kakao此前已在13日举行的“if(kakao)26”活动上披露相关发布计划。
视觉编码器主要负责从图像中提取物体、文字、位置和形态等信息,并将其传递给语言模型。在多模态AI系统中,这类模型承担图像理解任务,可用于读取菜单、文档内容以及理解照片场景等。
据Kakao介绍,公司对这两款模型进行了内部评测,覆盖通用视觉问答(VQA)、英文和韩文文字识别(OCR)及文档理解、图像内位置定位、细粒度识别等9个方向,共42项基准测试。
Kakao称,评测结果显示,这两款模型整体性能优于Google的“SigLIP 2”、Meta的“Perception Encoder”、Apple的“AIMv2”以及Alibaba的“Qwen3.5-ViT”等同类模型。
其中,Tiny版是一款参数量不足1亿的轻量模型。Kakao表示,该模型在图像内位置定位、韩语考试相关任务、韩语OCR和文档理解等方向上,与对比模型拉开了性能差距。
Kakao还表示,在视觉编码器训练过程中引入自研语言模型“Kanana-2”后,训练效率提升约4倍。同时,得益于面向高分辨率图像处理的设计,模型处理时延较主要对比模型降低60%以上。
此外,公司还采用了知识蒸馏和轻量化技术,在推出Medium版的同时,也开发了面向端侧场景的Tiny版。
两款模型均按“Kanana Open License”开源,除科研和开发用途外,也支持商业使用。
Kakao表示,除视觉编码器外,公司也在推进语言模型以及视觉、语音处理模块等相关技术研发,并构建全模态模型“Kanana-o”。后续还将按计划陆续开源其他组成部分。
Kakao统一基础模型成果负责人Byungseok Roh表示,随着“计算机使用”技术受到关注,能够对高分辨率图像进行精准分析的视觉编码器正变得愈发重要。公司将继续提升自研AI模型竞争力,并持续对外公开相关技术。
 Ho-jung Lee
lhj@d-today.co.kr