
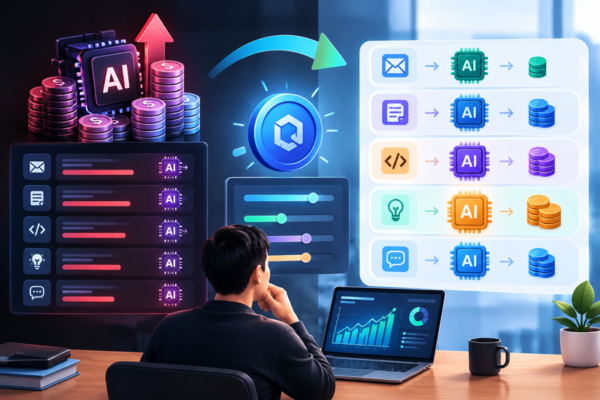
调查显示,尽管顶级AI模型的单价最高可比小模型高出100倍,但不少企业和用户在邮件撰写、内容摘要等基础场景中,依然默认调用高性能模型。随着AI Agent和自动化工具使用范围扩大,Token消耗迅速上升,如何按任务选择模型、控制调用规模,正成为企业AI成本管理的核心议题。
区块链媒体Decrypt于10月17日援引消息称,Meta员工今年早些时候在30天内累计消耗了60万亿枚AI Token,背后原因之一是公司内部围绕AI使用量的排名竞争升温。技术专栏作者Gergely Orosz按照Anthropic公开定价估算,这一规模对应的费用约为9亿美元,不过这一数字基于官方标价,Meta的实际支出可能更低。
类似的“AI用量竞赛”并非Meta独有。报道称,Meta、Amazon、Uber等科技公司都曾在内部设置使用量排行榜,对员工使用AI工具的情况进行比较。另有消息显示,Uber在约4个月内就用完了2026年AI工具预算。
Nvidia CEO Jensen Huang也在持续推动扩大AI使用规模。他今年3月在“All-In”播客中表示,如果一名年薪50万美元的工程师,使用的Token价值不足25万美元,他会“非常担忧”。业内认为,企业鼓励员工借助AI提升生产效率的同时,也可能在无形中放大用量竞争,并进一步转化为成本压力。
从成本端看,不同模型之间的价格差异本身就十分明显。Anthropic和OpenAI的顶级模型,单个Token的价格最高可比各自最小型号高出100倍。以OpenAI为例,按输入Token计费的产品中,部分型号每百万输入Token收费10美元,也有型号仅为0.10美元。
Token是AI处理和生成文本的基础计量单位,既包括用户输入的问题和上下文,也包括模型输出的回答。对于月费约20美元的订阅型产品,Token消耗速度会直接影响可用额度;而对通过API接入AI服务的企业而言,调用量上升则意味着账单同步增加。
咨询公司Bain & Company的Juye Wang表示,一些企业即便在并不需要复杂推理的任务中,也会直接调用顶级模型。例如邮件撰写等场景,也统一使用Anthropic的高性能模型Opus。
Amazon内部也出现过类似情况。报道称,部分员工会将公司内部AI工具用于与本职工作关联度不高的任务,以拉高个人使用量。一名高级副总裁为此警告员工,不要为了使用AI而使用AI。如果把调用规模当作绩效指标,可能在没有明显提升生产力的情况下徒增成本。
除了模型选用不当,AI Agent和任务编排也是推高成本的重要因素。AI Agent完成任务通常涉及搜索、代码执行、结果复核等多个环节;如果在过程中反复传递历史对话和任务上下文,Token消耗会明显增加。若再将任务拆分给多个子Agent协同处理,调用次数和上下文处理量还会进一步放大。
Anthropic提醒,在Claude Code中,团队型Agent以“计划模式”运行时,Token用量可能达到普通对话的约7倍。这意味着,Agent自主处理复杂任务的能力越强,即便用户直接输入变少,后台的Token消耗仍可能继续上升。
在控制成本方面,首要做法是根据任务难度分层选模。邮件撰写、语句润色、简单摘要等基础工作,可优先交给小模型处理;只有在复杂推理、关键判断等对准确性要求更高的场景中,再调用顶级模型。
在实际使用中,企业也可以把近期若干相似任务分别交给高性能模型和小模型处理,比较输出效果。如果小模型已经满足需求,就可以在同类任务中持续采用。报道称,借助这类“模型分流”策略,API成本最高可下降99%,但实际节省幅度仍取决于任务类型、模型定价和总体使用量。
提示词设计和上下文管理同样关键。与其反复追问、不断补充要求,不如在一开始就明确核心需求和输出格式,以减少不必要的往返调用。对话主题发生变化时,及时开启新会话,也能避免旧上下文被持续带入,造成额外消耗。
Anthropic将长对话中无关信息不断累积、并导致回答质量下降的现象称为“context rot”。上下文越长,模型需要处理的Token越多,也越难聚焦真正关键的信息。
控制回答长度,同样可以直接降低费用。Anthropic和OpenAI的部分顶级模型中,输出Token单价约为输入Token的5倍。因此,加入“在100词内作答”或“仅输出修改部分”等限制条件,有助于避免结果冗长,减少不必要的开销。
对于计算和汇总类任务,也没有必要全部交给AI完成。与其将整张长表输入模型后再要求分析,不如让模型先生成所需公式或简短脚本,由用户自行执行,再把结果返回给AI。用通用工具替代推理链条中的重复计算,同样能有效减少Token消耗。
在开发场景中,缓存和批处理也被视为重要的降本手段。将重复使用的系统指令和固定上下文进行缓存,可以减少每次重复输入带来的成本。OpenAI和Anthropic也为批处理任务提供50%的折扣,适用于对实时性要求不高的大批量工作。
例如,将1000笔账单集中批量处理,而不是逐笔实时调用,就能有效压低调用成本。不过,企业在使用缓存和批处理前,仍需确认平台支持条件及适用任务类型。
对于AI Agent,还需要预先设定执行步数和支出上限。在任务开始前明确完成标准,并设置最大执行轮次和预算额度,可以避免Agent为追求“更优结果”而反复尝试。报道称,Shopify目前已运行一套相关机制:一旦单日支出突然上升,就会立即中断开发者访问。
值得关注的是,尽管Token单价持续下行,企业总支出却仍在上升。SiliconData的Token支出指数显示,自2023年以来,单个Token价格已下降逾90%,但与大语言模型(LLM)相关的支出自2025年底以来翻了一番。Bain & Company分析称,在2024年12月至2025年间,Token成本降至原来一半的同时,使用量却增长了450%。
这也意味着,模型价格下降并不必然带来总成本下降。当用量增长速度快于单价下降速度时,企业整体支出反而可能继续扩大。
因此,降低AI成本不能只停留在“选更便宜的模型”这一步。企业需要建立一套完整的运营机制,包括按任务分配模型、优化提示词和上下文管理、限制Agent重复执行、加强预算控制等。随着企业在AI领域的竞争重点,从“谁用得更多”转向“谁用得更有效”,衡量标准也正在从使用规模转向投入产出效率。
 Jinju Hong
hongjj@d-today.co.kr