
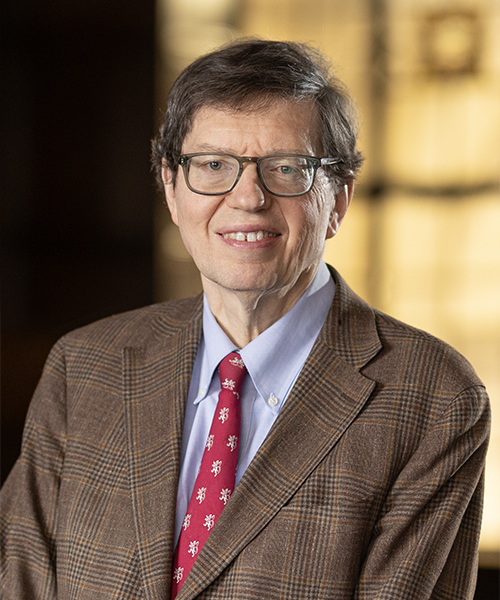
“前沿AI本身就是一道‘防火墙’。如果放缓开发,新型防御能力的形成也会被推迟,但现实中的威胁并不会因此消失。” Northwestern University法学院教授John O. McGinnis近日在《华尔街日报》撰文称,刻意放慢前沿AI研发节奏,牺牲的可能不仅是技术进步,也包括安全防御能力。
这篇文章是对近期“应放缓前沿AI开发”的一种回应。John O. McGinnis在文中将AI风险概括为两类:其一是AI脱离人类控制并引发事故;其二是AI在恶意指令驱动下被用于实施危害。
他提到,Anthropic首席执行官Dario Amodei近期主张放慢前沿研发速度,以便为企业间协调和模型测试争取更多时间。对此,John O. McGinnis认为,这样的做法或许有助于压低第一类风险,但也可能拖慢针对第二类风险的防御工具开发。
在他看来,关于“AI失控”风险的严重程度,学界和产业界至今仍有分歧;但犯罪分子、恐怖组织以及中国、俄罗斯等威权国家滥用AI的风险,并非假设性问题。他指出,从历史经验看,恶意个人和压迫性国家几乎总会利用最新技术制造破坏。
John O. McGinnis进一步举例称,如果犯罪分子试图借助现有模型突破医院安保体系,那么能力更强的模型反而可能在攻击发生前帮助提升防御水平。换言之,放缓开发并不会让不法分子手中的现有工具自动消失。
在网络安全场景中,他还援引Palo Alto Networks的案例显示,Anthropic的Claude Mythos能够识别此前模型未能发现的复杂漏洞。这也被他用来说明,更先进的模型未必只会放大风险,也可能提升防御能力。
对于“更强模型本身也可能成为犯罪工具”的质疑,John O. McGinnis表示,推进更先进模型研发,并不等于毫无限制地向外部开放。他称,美国的前沿AI企业通常会加入防止模型被用于恶意攻击的安全机制;同时,出于法律责任和声誉风险考量,这些企业也有动力持续监测并封禁恶意账户。
他还写道,Anthropic曾于4月向JPMorgan Chase等客户提供尚未公开的Claude项目;Google也会在医疗和金融网络环境中,先向部分用户开放新功能试用。在他看来,这类做法的意义在于,让防御方先一步获得新工具。
不过,John O. McGinnis也警告称,中国企业推出的开源权重模型可能带来新的问题,因为这类模型更容易被用户修改并用于滥用。他认为,即便通过国际条约放慢开发速度,也无法消除已经扩散出去的模型,并以“精灵已经从瓶子里出来了”作比。
文章最后,John O. McGinnis将这一逻辑进一步延伸至国家安全层面。他表示,如果美国政府能够率先使用尚未公开的先进模型,就可能在军事上形成显著优势;而其他国家一旦意识到这一点,甚至可能因此不敢轻易发动攻击。
 Chi-gyu Hwang
delight@d-today.co.kr