
Kakao公布了其AI个性化与安全设计方向,明确将用户“记忆”的使用范围与AI代理的执行权限区分开来。按照公司的设想,AI可以在用户同意的范围内获取必要上下文,但具体任务的执行仍须严格限定在用户授权边界之内。
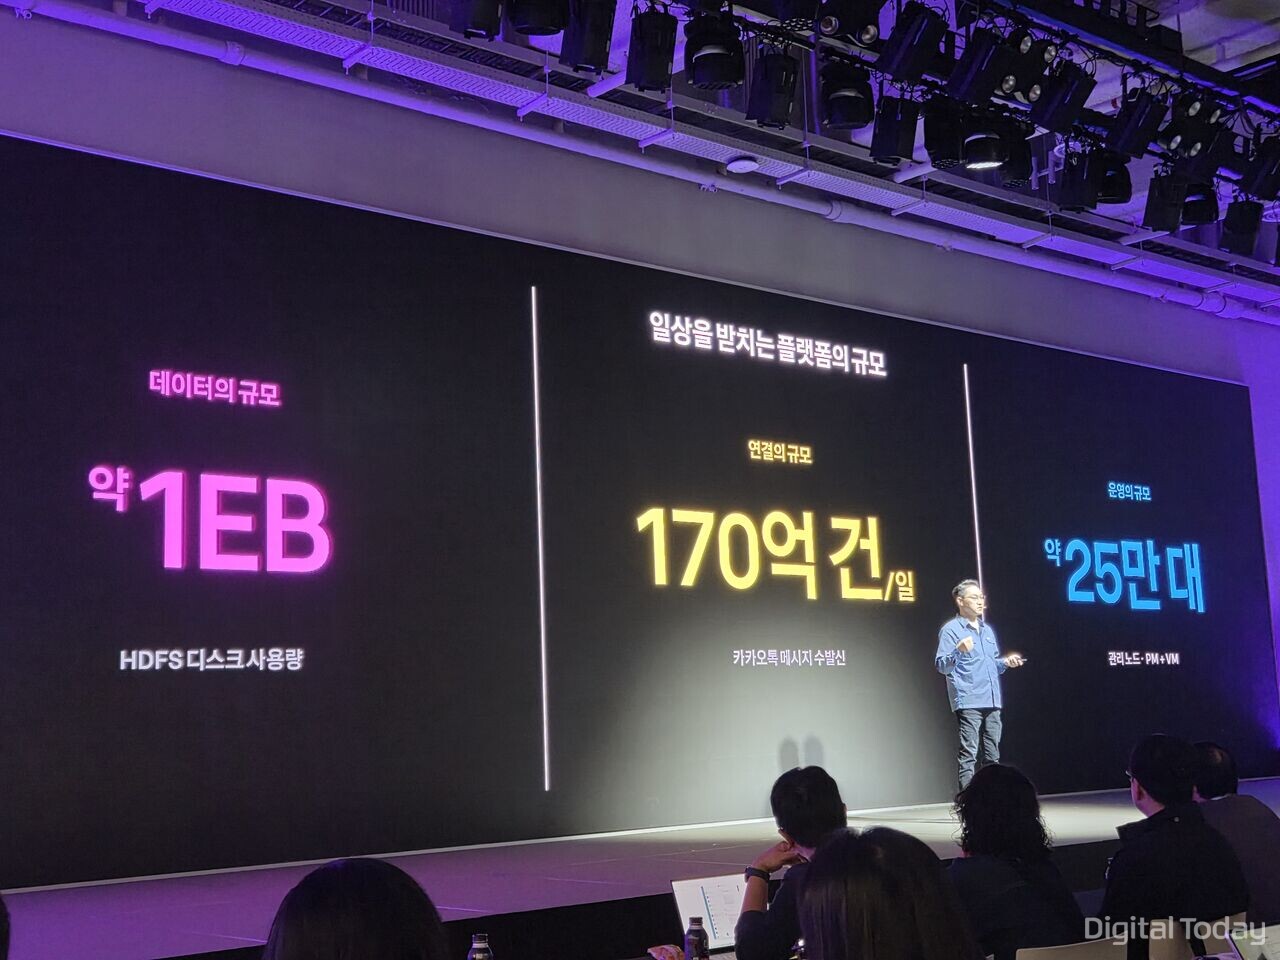
13日,Kakao在京畿道龙仁市Kakao AI Campus举行的“if(kakao)26”活动上,介绍了个性化项目“Project Mosaic”、代理安全验证机制,以及自研AI模型的调度策略。
Kakao首席技术官(CTO)Song Jae-ha表示,“记忆可以作为判断依据,但不能直接转化为行动权限。”他指出,理解用户偏好是一回事,获得下单、预约等操作授权则是另一回事,二者必须分开处理。
在Kakao看来,购买记录并不等于用户偏好,相关“记忆”也只能提供给用户明确同意的服务使用。
“Project Mosaic”旨在让KakaoTalk、Kanana Space、Canvas以及多个代理之间,持续复用完成任务所需的上下文信息。其目标是减少用户在切换服务或代理时,反复从头说明此前选择过的商品和当前进行中事项的负担。
Kakao表示,目前正先行梳理自有数据的采集目的和用户授权边界,并据此制定接入和使用标准。具体机制是,先将各项服务中产生的信息整理为“记忆”,再把其中获准共享的部分提供给发起请求的服务或代理。
在整理“记忆”的过程中,平台会区分客观事实与系统解释,并记录信息来源和时间点。Song Jae-ha举例称,如果用户是为了送给侄子而购买童鞋,系统若仅根据购买记录就判断其偏好童鞋,后续就可能出现持续错误推荐。至于配送状态、偏好等会随时间变化的信息,也需要持续确认其是否仍然有效。
Song Jae-ha表示,“如果AI会记住我,它也必须记住,我是会改变的。”
在记忆共享范围上,Kakao将以服务维度的用户授权为边界。也就是说,仅授权A服务使用的记忆,只能提供给A服务;即便属于同一用户的信息,如果B服务没有获得相应同意,也不能提供给B服务。
如果用户撤回对原始信息或其使用范围的授权,系统将自后续请求起停止提供相关记忆。不过,Kakao也表示,这一机制并不意味着会自动回收其他服务已经接收并保存的记忆。
对此,Song Jae-ha解释称,阻止后续继续提供记忆,与管控已经传递出去的记忆使用,是两件不同的事。如何在使用既有记忆的同时继续保障用户选择权,需要由服务侧与记忆提供平台共同解决。
在代理安全方面,Kakao提出的原则是,不能因为代理能够调用“记忆”,就相应扩大其执行权限。公司强调,必须清晰界定用户委托条件,例如允许购买的商品范围、金额上限等;即便任务被转交给其他代理处理,也必须遵守同一授权边界。
例如,在下单过程中,即便系统收到“将缺货商品替换为其他商品”的指令,只要这一操作超出用户原先委托范围,代理就不应直接执行,而应再次向用户确认。
Song Jae-ha表示,基本原则就是“授权范围内可继续执行,超出范围必须再次确认”,而这一边界不能完全交由模型自行判断。
在安全验证方面,Kakao的检测范围并不局限于最终回复内容。公司计划在测试环境中搭建缺货、价格变动等场景,追踪代理基于何种判断调用了哪些工具,对整个执行链路进行验证。原因在于,即便代理最终回答“未下单”,如果此前已经调用过下单API,外部系统中的实际操作仍可能已经发生。
此外,Kakao还将检查用户请求、记忆信息和当前上下文中,是否混入与用户意图不符的指令,并在执行前对据此生成的行动计划进行二次校验;在服务层面,还需要进一步确认账户权限以及本次任务实际授予的范围。
Song Jae-ha强调,评估标准不仅要看“是否拦截了危险操作”,也要看“是否正确处理了正常请求”。Kakao的目标并不是通过拒绝所有请求来降低风险,而是在允许的任务可以顺利执行的同时,拦截越权操作。
面向大规模用户提供个性化代理服务,Kakao也披露了相应的模型调度策略。公司表示,代理既需要理解用户上下文,也需要完成多步骤任务,因此在保证响应质量的同时,还必须兼顾速度与成本效率。
Kakao称,凡是可由智能手机端处理的请求,将优先交由端侧模型完成,再决定是否发送至服务器,以降低响应时延,并减少敏感信息对外传输的范围。对于需要最新信息、复杂推理或连接外部服务的任务,则由服务器模型处理。
“AI Conductor”则负责将用户目标拆解为多个步骤,并选择合适的模型、工具及执行顺序。Kakao表示,这一机制可根据请求复杂度分配模型资源,减少不必要的大模型调用和推理成本。
Kakao Foundation Model负责人Noh Byeong-seok表示,“我们会为所有请求提供最好的结果,但不会为所有请求都动用最大的模型。”
 Ho-jung Lee
lhj@d-today.co.kr